Série IA além dos chatbots · #01. Este artigo abre uma sequência sobre como os dados que uma organização já possui podem ajudar a prever resultados, identificar riscos e apoiar decisões.
Uma empresa reúne numa planilha o histórico de pedidos, prazos, tipos de cliente, regiões e atrasos. A pergunta parece simples: quais pedidos correm maior risco de não chegar no prazo?
Uma floresta de decisão pode ajudar a responder. Esse tipo de modelo trabalha especialmente bem com dados organizados em linhas e colunas e consegue combinar muitas perguntas simples: o prazo é curto? O produto depende de fornecedor externo? Essa região teve mais atrasos? O pedido é maior que o habitual?
O resultado não vem de uma regra escrita manualmente. O modelo aprende, com exemplos anteriores, quais divisões dos dados ajudam a prever um resultado.
Primeiro, entenda uma árvore de decisão
Uma árvore começa na raiz (o nó inicial) e conduz cada exemplo por uma sequência de condições. Os nós internos contêm perguntas; as folhas — os nós finais — contêm a previsão.
Em uma tarefa de classificação, a folha pode indicar “alto risco” ou “baixo risco”. Em regressão, pode trazer um número, como a quantidade provável de vendas.
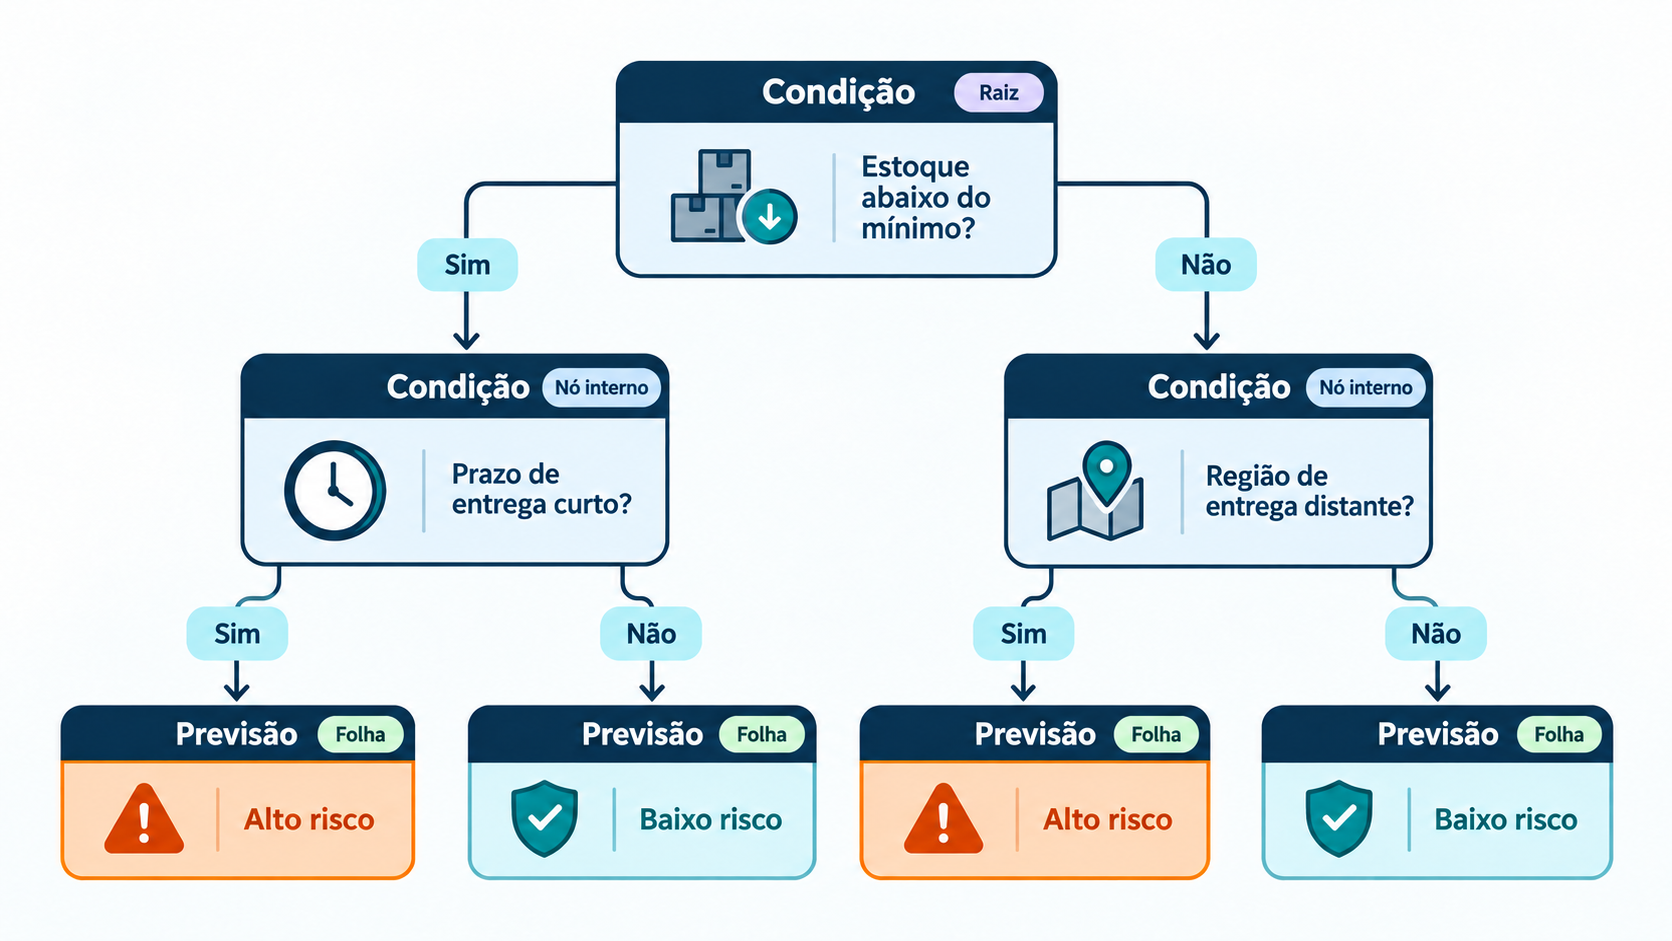
Uma árvore isolada é fácil de visualizar, mas pode se ajustar demais aos exemplos que recebeu. As florestas reduzem esse problema combinando várias árvores.
Nem toda floresta combina árvores da mesma maneira
Floresta aleatória: vários avaliadores independentes
Na Random Forest, cada árvore é treinada com uma amostra dos registros e considera subconjuntos das variáveis. É como consultar vários avaliadores que receberam partes diferentes do material. Na classificação, as previsões são combinadas por votação ou média de probabilidades. Na regressão, normalmente se usa a média dos valores previstos.
Gradient boosting: uma sequência de revisores
No gradient boosting, as árvores não trabalham de forma independente nem simplesmente votam. Elas são construídas em sequência: cada nova árvore tenta corrigir parte do erro deixado pelas anteriores, e suas contribuições são somadas.
É como uma revisão em etapas. O primeiro revisor produz uma versão inicial; o seguinte procura os erros que permaneceram; os próximos refinam o resultado.
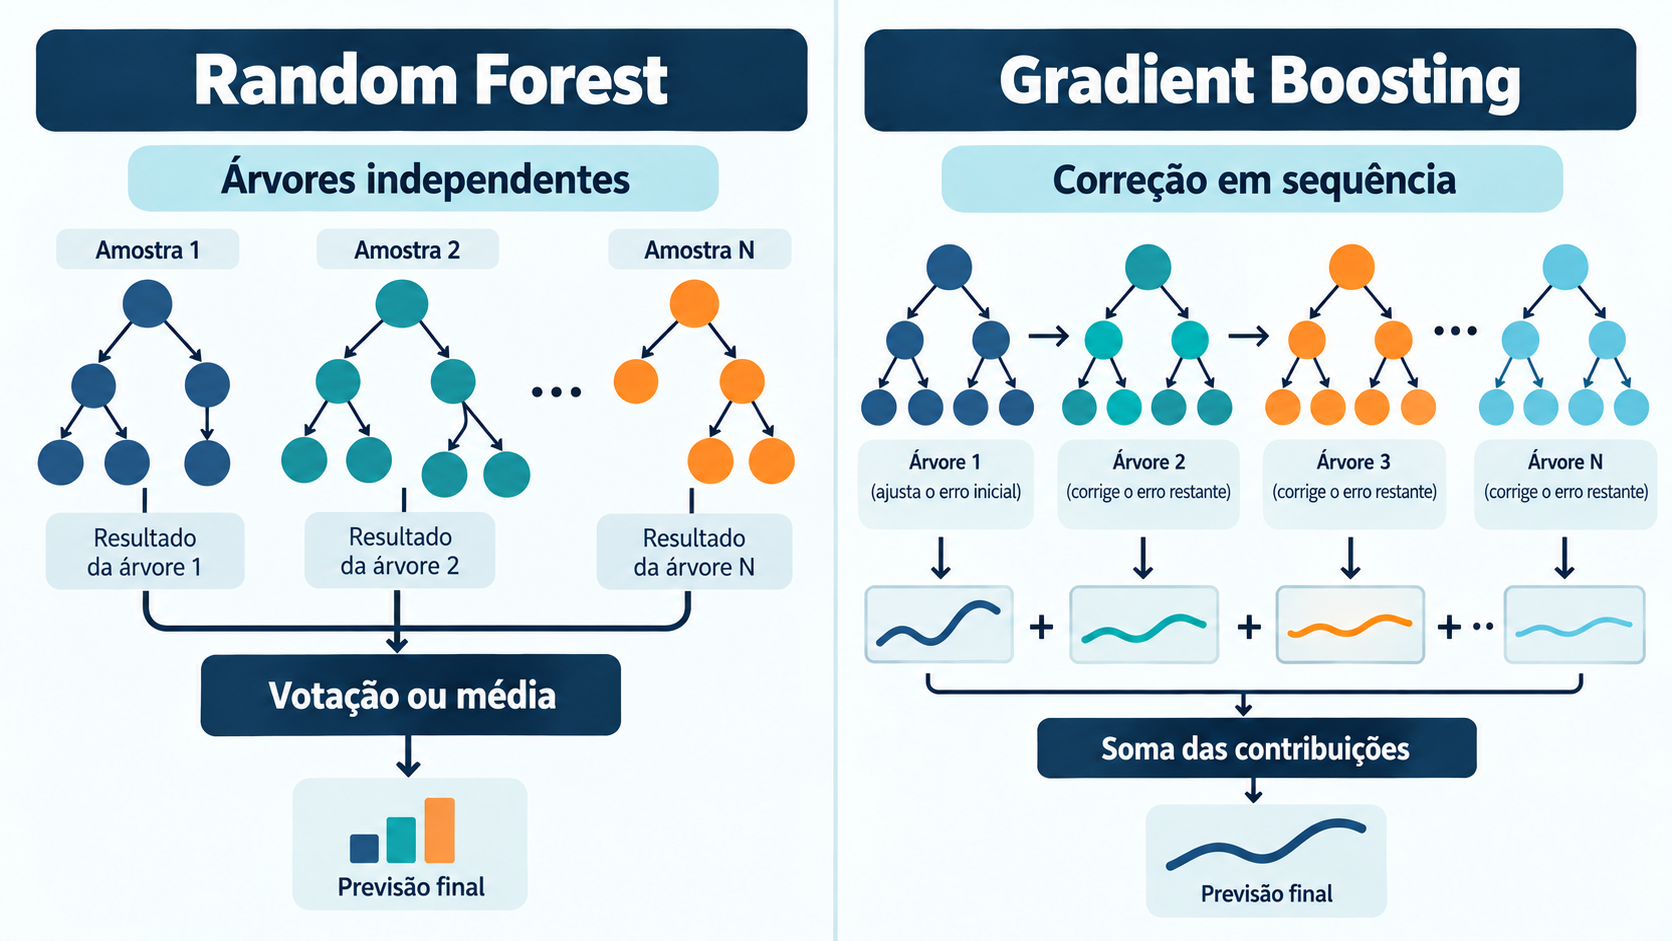
É nessa família que aparecem nomes que o leitor encontrará em ferramentas e vagas de trabalho: Random Forest, XGBoost, LightGBM e CatBoost.
Por que esses modelos são úteis para dados de empresas?
Segundo o curso do Google sobre florestas de decisão, esses modelos conseguem trabalhar com variáveis numéricas e categóricas e, dependendo da implementação, com valores ausentes. Em muitos casos, exigem menos pré-processamento que uma rede neural.
O curso também destaca que as florestas têm poucos hiperparâmetros e que suas configurações padrão costumam funcionar bem. Para conjuntos com menos de 1 milhão de exemplos, elas geralmente treinam e fazem previsões muito mais rápido que redes neurais. Isso não significa que todo conjunto pequeno produzirá bons resultados: a qualidade depende dos dados, da pergunta e da avaliação.
Elas podem ser usadas em classificação, regressão, ranking e modelagem de uplift. O Google também inclui detecção de anomalias, mas aqui existe uma diferença importante.
Detecção de anomalias pode dispensar uma resposta histórica
Para prever atraso, fraude confirmada ou vendas, o treinamento supervisionado precisa de uma coluna com o resultado conhecido. O modelo compara suas previsões com essa resposta e ajusta suas regras.
Já uma técnica como Isolation Forest costuma funcionar de modo não supervisionado. Ela não precisa receber casos rotulados previamente como “normal” e “anomalia”. Em vez disso, cria partições aleatórias e identifica observações que ficam isoladas com poucos cortes. Esses casos merecem investigação, mas não são automaticamente erros ou fraudes.
Portanto, a falta de uma coluna de resposta não impede toda aplicação com florestas. Ela muda a tarefa e também a maneira de avaliar o resultado.
Um exemplo: prever atrasos em pedidos
Imagine uma base em que cada linha representa um pedido. As colunas podem registrar:
- data e região;
- categoria do produto;
- quantidade solicitada;
- prazo prometido;
- fornecedor;
- modalidade de entrega;
- resultado final: entregue no prazo ou atrasado.
O último campo é a resposta que um modelo supervisionado tentará prever. Antes do treinamento, porém, é preciso conferir se os registros estão completos, se os conceitos são consistentes, se a amostra representa a operação real e se todas as colunas escolhidas já existiam no momento da decisão.
Também é essencial excluir informações que só surgem depois da previsão. Usar a data real de entrega para prever atraso produziria um resultado artificialmente bom. Esse problema se chama vazamento de dados e aparece com mais detalhes no artigo Como testar uma IA sem deixar que ela veja a prova antes.
A avaliação precisa imitar o uso real
Os dados devem ser separados entre treinamento e avaliação. Quando o objetivo é prever acontecimentos futuros — demanda, prazos ou vendas —, essa separação deve respeitar a ordem do tempo: treina-se com períodos anteriores e testa-se em períodos posteriores.
Misturar aleatoriamente registros do futuro no treinamento pode tornar o teste mais confortável que a operação. O artigo Por que uma IA acerta nos testes e erra na vida real? explica por que casos realmente novos importam. Para escolher métricas e examinar os erros relevantes, vale também consultar Como saber se um modelo de IA é realmente bom?.
O limite que mais importa na previsão de demanda
Árvores de regressão e florestas baseadas na média, como Random Forest, não extrapolam além dos valores observados no treinamento. Se a maior demanda conhecida foi de 1.000 unidades, o modelo não aprenderá sozinho a projetar 1.200 apenas porque existe uma tendência de crescimento.
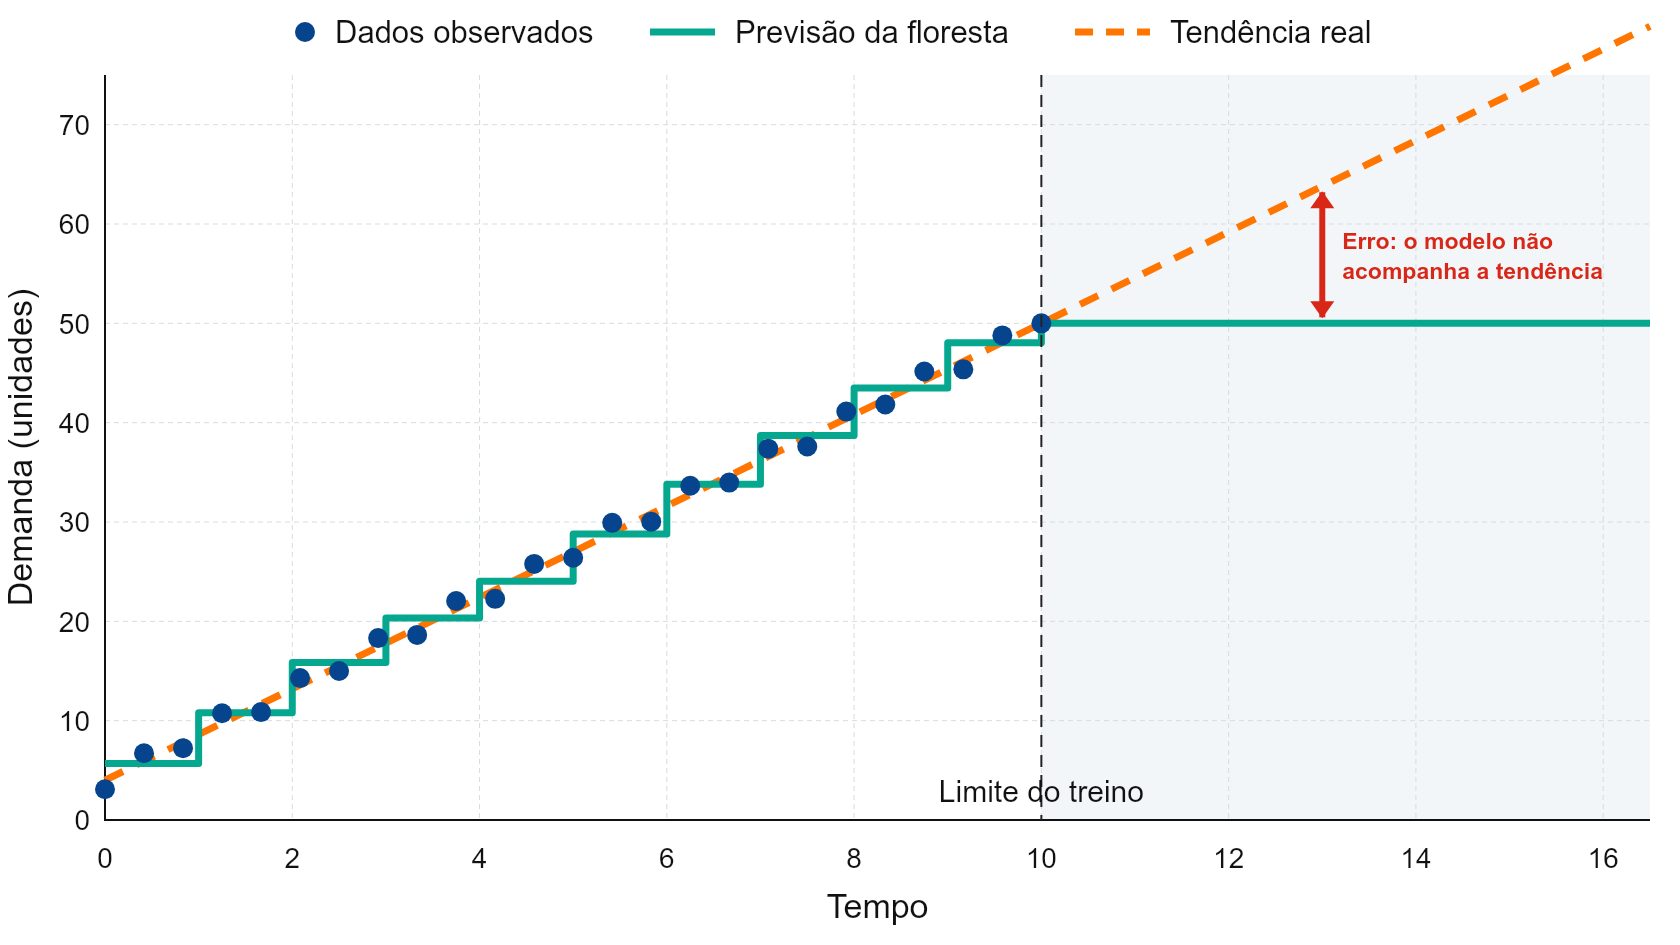
Modelos de gradient boosting podem, por sua construção aditiva, ultrapassar a faixa observada em algumas situações. Isso não os transforma em bons extrapoladores: fora da região conhecida, previsões baseadas em árvores tendem a ser frágeis.
Para demanda com tendência, expansão geográfica ou mudança de escala, é preciso testar alternativas que representem o tempo e a tendência, além de avaliar o modelo em períodos futuros. Essa discussão se conecta ao artigo Quando a vida faz curva: por que uma IA não pode prever tudo em linha reta.
Explicável não significa autoexplicativo
Florestas permitem examinar regras, importância das variáveis e comportamento das previsões. Ainda assim, a medida de importância baseada na redução de impureza, comum em bibliotecas, pode favorecer colunas com muitos valores distintos.
A importância por permutação ajuda a reduzir esse viés. Para entender uma previsão individual, métodos como SHAP podem mostrar quais variáveis empurraram o resultado para cima ou para baixo. Nenhuma dessas técnicas, isoladamente, prova causa e efeito.
Outro cuidado envolve probabilidades. Se o modelo atribui 0,8 a um risco, isso não garante que oito em cada dez casos semelhantes acontecerão. Essa interpretação só é válida quando as probabilidades foram avaliadas e estão bem calibradas.
Quando uma floresta faz sentido — e quando não faz
Vale considerar uma floresta de decisão quando:
- os dados estão organizados em tabelas;
- existe uma pergunta operacional clara;
- para classificação ou regressão, há resultados históricos confiáveis;
- a equipe consegue testar o modelo com casos novos;
- alguém acompanhará erros e mudanças depois da implantação.
Para detecção não supervisionada de anomalias, os rótulos podem não existir, mas ainda é preciso validar se os alertas são úteis.
Florestas não costumam ser a primeira escolha para consumir diretamente imagens, áudio ou textos longos. Redes neurais são mais adequadas para esses dados não estruturados, embora uma floresta possa trabalhar com características extraídas deles.
Também não basta obter uma boa pontuação. A empresa precisa decidir o que fará com a previsão, quanto custa cada tipo de erro e quando uma pessoa deve revisar o caso.
Variáveis pessoais — ou colunas que funcionem como substitutas delas — podem reproduzir ou ampliar decisões discriminatórias. Uma pontuação de risco não autoriza, por si só, recusar um cliente, restringir um direito ou avaliar o valor de uma pessoa.
Em resumo
Uma árvore transforma condições em uma previsão. Uma Random Forest combina árvores treinadas com variações dos dados e das variáveis. O gradient boosting constrói árvores em sequência para corrigir erros anteriores. A Isolation Forest procura observações que se isolam rapidamente, sem exigir necessariamente uma coluna de resposta.
Esses modelos são fortes candidatos para dados tabulares e podem ser rápidos, robustos e relativamente interpretáveis. Mas continuam dependentes de dados representativos, avaliação honesta e acompanhamento humano. Em especial, previsões de demanda exigem cuidado com o tempo e com a extrapolação além do que o modelo já viu.
Nota sobre as imagens: o diagrama da árvore e a comparação entre Random Forest e Gradient Boosting são ilustrações produzidas com auxílio de inteligência artificial; o gráfico de extrapolação é didático, com valores ilustrativos.
Fontes
- Google for Developers. Florestas de decisão. Acesso em: 12 out. 2026.
- Google for Developers. Árvores de decisão. Acesso em: 12 out. 2026.
- Google for Developers. Dados apropriados para florestas de decisão. Acesso em: 12 out. 2026.
- scikit-learn. IsolationForest. Acesso em: 12 out. 2026.
- scikit-learn. Árvores de decisão. Acesso em: 12 out. 2026.
- scikit-learn. Importância das variáveis por permutação e por impureza. Acesso em: 12 out. 2026.
- scikit-learn. Calibração de probabilidades. Acesso em: 12 out. 2026.
Quer receber mais guias práticos sobre IA e trabalho?
Assine a newsletter e receba conteúdos objetivos para aplicar no trabalho e na carreira.
Quero receber os conteúdos
Mestre em Educação Profissional e Tecnológica, engenheiro de software e profissional de transformação digital. Produz conteúdos sobre inteligência artificial, carreira e desenvolvimento pessoal e profissional.