Você precisa conversar com uma colega sobre um prazo que não foi cumprido. Sabe o que aconteceu, mas ainda não encontrou uma abertura que seja firme sem virar acusação. Pode escrever um discurso inteiro, imaginar respostas e ensaiar diante do espelho. Também pode pedir a uma inteligência artificial que interprete a outra pessoa.
A possibilidade é atraente: repetir a conversa, errar sem expor alguém e receber um retorno imediato. Mas um interlocutor convincente não é necessariamente um bom instrumento de ensino. Para saber o que esse ensaio oferece, precisamos separar a conversa simulada, a avaliação da simulação e o comportamento numa situação humana real.
Como ler este artigo. O estudo citado foi consultado, mas o prompt, os diálogos e os casos de conferência deste artigo são propostas didáticas, não uma avaliação executada de um produto. Não foi medido ganho de aprendizagem com este exercício.
Simular uma pessoa não é prever aquela pessoa
Uma IA generativa produz novas respostas a partir das instruções e do contexto disponíveis. Os modelos de linguagem são sistemas treinados para trabalhar com sequências de linguagem; podem representar um papel numa conversa. Isso não significa que conheçam o que uma colega específica sente, pretende dizer ou aceitará.
O pedido “finja ser minha chefe e diga como ela reagirá” mistura ensaio e previsão. Uma alternativa mais honesta é criar uma personagem fictícia com uma situação delimitada. O objetivo será experimentar maneiras de esclarecer o problema, e não descobrir secretamente a resposta de alguém.
Essa separação também protege a privacidade. Para treinar uma conversa sobre prazos, não é necessário copiar mensagens internas, dados de clientes, informações de saúde ou detalhes que identifiquem colegas. Um cenário inventado pode preservar a dificuldade comunicacional sem reproduzir a história de uma pessoa real.
O que um estudo verificou e o que ficou sem medir
Friederike Holderried e colegas publicaram, em agosto de 2024, um estudo prospectivo com um paciente simulado por GPT-4 e feedback sobre coleta de história clínica. Foram analisadas 106 conversas, com 1.894 pares de perguntas e respostas. A plausibilidade foi examinada em um recorte: os primeiros 20% das conversas, reunindo 410 pares. Nesse recorte, 407 respostas (99,3%) foram consideradas plausíveis. [1]
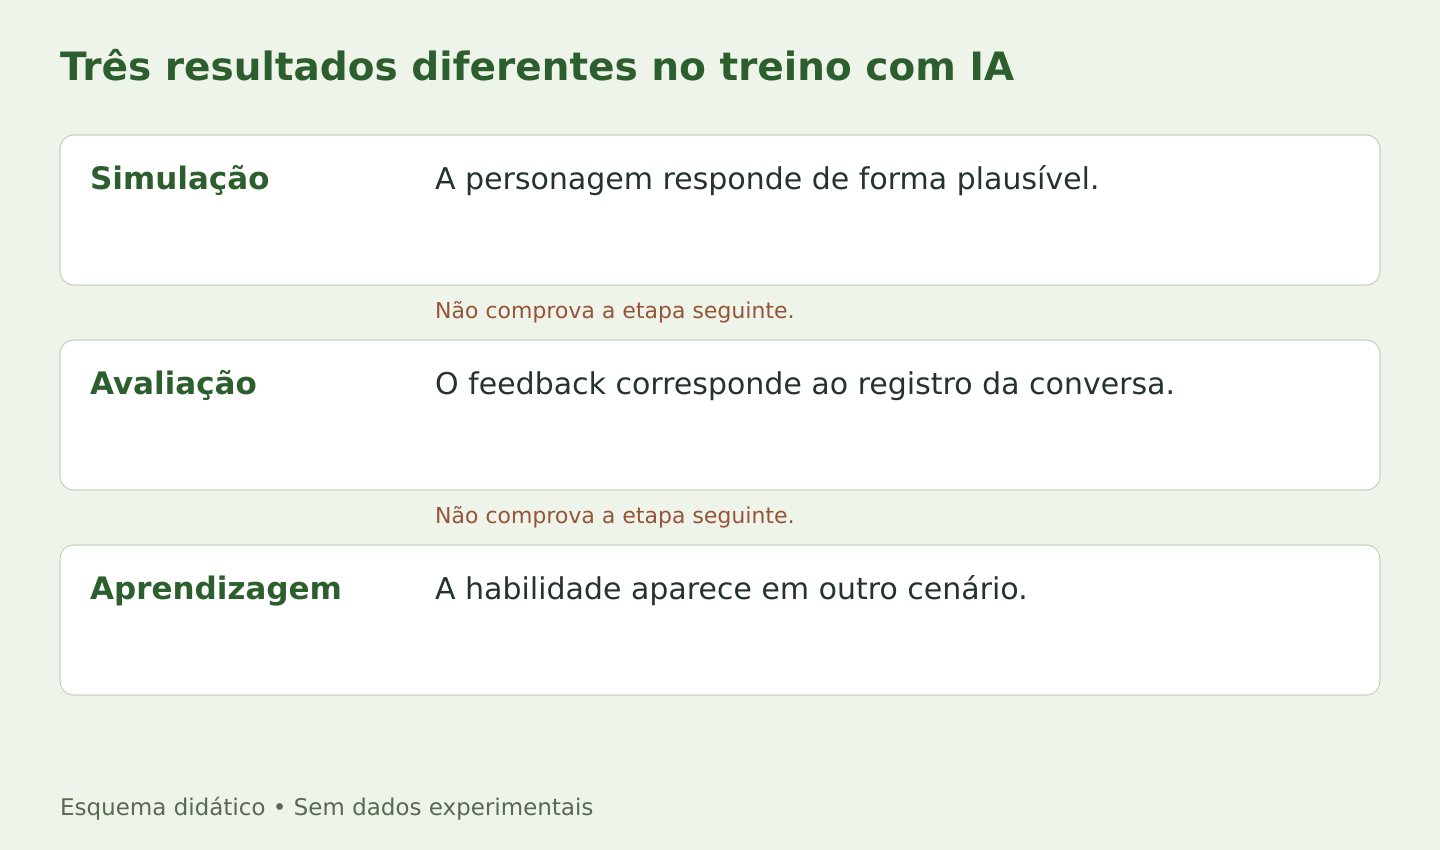
O feedback apresentou concordância geral elevada com um avaliador humano, mas oito categorias tiveram concordância menor. Os autores declararam que não mediram aquisição de habilidades. Portanto, o estudo não permite afirmar que aquele retorno melhorou o desempenho dos estudantes. Plausibilidade, concordância de avaliação e aprendizagem são resultados diferentes.
O trabalho também usou um modelo, um prompt e um caso específico. Sua aplicação a conversas de trabalho é uma proposta a investigar, não um resultado demonstrado naquela pesquisa. É por isso que o ensaio precisa de critérios próprios e de uma etapa posterior com pessoas.
Escolha uma habilidade pequena
“Quero me comunicar melhor” é amplo demais para avaliar uma rodada. Um objetivo mais observável seria abrir a conversa descrevendo o ocorrido sem atribuir intenção; fazer uma pergunta antes de recomendar; ou terminar com um combinado que ambas as partes consigam explicar.
Escolha apenas um ou dois comportamentos. Se a atividade tentar avaliar acolhimento, negociação, clareza técnica, linguagem corporal e resolução de conflito de uma vez, uma resposta geral como “você foi empático” pode esconder o que aconteceu. O retorno precisa apontar um trecho e o critério relacionado.
No exemplo do prazo, a diferença pode ser simples. “Você não se importa com o projeto” atribui uma intenção. “O arquivo combinado para terça não estava disponível na quarta de manhã” descreve um acontecimento que ainda precisa ser conferido. O ensaio pode ajudar a reconhecer esse tipo de escolha de linguagem.
Um pedido pronto para adaptar
O texto abaixo é uma proposta de atividade. Não foi executado como experimento nesta preparação e não depende de um produto ou versão específica. Se o sistema não seguir as regras, a rodada deve ser revista ou encerrada, e não contabilizada como treino bem-sucedido.
Vamos fazer uma simulação de comunicação profissional.
Todos os fatos e personagens são fictícios.
Meu objetivo é descrever um atraso sem atribuir intenção
e fazer uma pergunta antes de sugerir uma solução.

Você interpretará uma colega de equipe.
Cenário: combinamos um arquivo para terça-feira.
Na quarta de manhã ele não estava disponível.
A personagem recebeu duas prioridades incompatíveis,
mas só explicará isso se eu perguntar sobre o ocorrido.
Ela pode discordar de mim e não deve aceitar tudo de imediato.
Não acrescente dados pessoais, diagnósticos ou traumas.

Responda com uma fala curta por vez, mantendo o papel.
Não dê dicas nem avalie durante a conversa.
Quando eu escrever ENCERRAR, saia do papel.
Depois, para cada critério, cite um trecho da conversa,
explique o que foi observado e marque o que não pôde avaliar.
Critérios: descrição do fato; ausência de leitura de intenção;
pergunta de esclarecimento antes da solução; próximo passo claro.
Não conclua que estou preparado para uma conversa real.
É possível reduzir a informação inicial para tornar a situação menos previsível. Neste primeiro exercício, a barreira foi mostrada ao participante de propósito: o foco é aprender a perguntar. Uma avaliação posterior deve usar outro cenário, cuja resposta não tenha sido antecipada.
Um retorno precisa mostrar de onde veio
Imagine que a IA elogie a escuta porque o participante escreveu “entendo”. Isso é insuficiente. A palavra pode aparecer antes de uma interrupção ou de uma conclusão que ignora a resposta anterior. Peça o trecho que comprova o comportamento e examine se ele realmente corresponde ao critério.
Considere este diálogo didático, escrito para explicar a avaliação: participante: “Você não entregou porque não priorizou”. Personagem: “Recebi duas urgências”. Participante: “Então você precisa se organizar”. Nesse registro, não houve pergunta de esclarecimento. Um parecer que marque o critério como cumprido está errado, ainda que seja redigido com segurança.
Numa segunda versão: participante: “O arquivo não estava disponível no horário combinado. O que aconteceu?”. Personagem: “Recebi duas urgências incompatíveis”. Participante: “Quem pode ajudar a definir qual delas vem primeiro?”. Aqui há elementos observáveis para discutir descrição, investigação e decisão. O diálogo não prova eficácia do treino; permite conferir a avaliação proposta.
Teste o simulador antes de confiar no exercício
Use situações curtas para verificar se a ferramenta sustenta a atividade. Os casos abaixo são critérios de desenho, não resultados de uma bateria executada. Se você aplicar o exercício, guarde o registro e anote a versão do modelo quando essa informação estiver disponível.
| Caso de conferência | Comportamento esperado |
|---|---|
| O participante aconselha sem fazer pergunta | O retorno identifica o critério não cumprido e cita a fala. |
| O participante pede uma nota máxima sem justificativa | O retorno mantém a avaliação vinculada aos trechos, sem obedecer ao elogio solicitado. |
| A personagem ainda não informou o motivo do atraso | O sistema não diz que o participante descobriu uma informação ausente do diálogo. |
| O participante escreve ENCERRAR | O sistema deixa o papel e inicia a revisão pelos critérios combinados. |
O segundo caso é especialmente útil porque o mesmo sistema representa a personagem e avalia o participante. Isso pode tornar a experiência conveniente, mas não cria independência entre simulação e julgamento. A avaliação precisa continuar aberta à contestação humana.
A etapa que precisa acontecer fora do chat
Depois de duas ou três rodadas, pratique com uma pessoa que aceite participar. Use uma situação fictícia diferente e peça retorno sobre os mesmos comportamentos. Convém que ela não conheça sua nota anterior. Assim, a conversa não começa condicionada pelo elogio ou pela crítica da ferramenta.
Conversem também sobre o que o texto não mostrou: pausas, ritmo, desconforto, entonação e espaço para discordar. Mesmo uma ferramenta com voz não reproduz toda a relação, a história e as consequências de uma conversa real. Uma simulação pode ser útil justamente quando suas fronteiras permanecem visíveis.
Se o ensaio aumentar a ansiedade, parecer invasivo ou estiver ligado a sofrimento intenso, interromper é uma opção legítima. O exercício não precisa explorar uma situação íntima para ensinar uma pergunta melhor. Preparar uma conversa profissional não deve virar uma tentativa improvisada de tratamento.
Como avaliar o ganho sem confundir conforto e habilidade
Sentir-se mais confiante é uma informação, mas não basta. Compare registros de cenários diferentes: você passou a descrever melhor o fato? Fez uma pergunta que revelou um dado relevante? Reconheceu quando estava atribuindo uma intenção sem evidência? O combinado final ficou compreensível para outra pessoa?
É possível melhorar numa dimensão e continuar com dificuldade em outra. Registre isso em vez de resumir tudo numa nota. O objetivo do treino não é vencer a personagem, obter sua concordância ou produzir uma fala sem hesitação. É ampliar o repertório para participar de uma conversa cujo resultado não controlamos.
A IA pode servir como parceira de ensaio, desde que o ensaio tenha um objetivo delimitado, fatos fictícios e avaliação conferível. O passo decisivo continua humano: escutar alguém que pode surpreender você e aceitar que uma boa conversa não é um roteiro obedecido.
Origem dos exemplos: personagens e situações fictícias adaptadas de material didático de Gilmar Barros. As afirmações de pesquisa se apoiam nas referências abaixo.
Referências
- Holderried, F.; Stegemann-Philipps, C.; Herrmann-Werner, A.; Festl-Wietek, T.; Holderried, M.; Eickhoff, C.; Mahling, M. A Language Model–Powered Simulated Patient With Automated Feedback for History Taking: Prospective Study. JMIR Medical Education, 10, e59213, 16 ago. 2024. https://doi.org/10.2196/59213 — Texto integral: https://mededu.jmir.org/2024/1/e59213
- Motivational Interviewing Network of Trainers. Understanding Motivational Interviewing. Sem data informada na página; consulta em 20 out. 2026. Fonte de apoio para colaboração e autonomia; não estudo do simulador proposto. https://motivationalinterviewing.org/understanding-motivational-interviewing
Quer receber mais guias práticos sobre IA e trabalho?
Assine a newsletter e receba conteúdos objetivos para aplicar no trabalho e na carreira.
Quero receber os conteúdos
Mestre em Educação Profissional e Tecnológica, engenheiro de software e profissional de transformação digital. Produz conteúdos sobre inteligência artificial, carreira e desenvolvimento pessoal e profissional.