Por Gilmar Barros • 24 de outubro de 2026 • Leitura estimada: 9 minutos
Capa conceitual gerada por IA. Não representa a equipe da pesquisa ou uma interface real.
Uma loja pede à inteligência artificial uma função para calcular frete. O programa roda, os testes ficam verdes e a equipe comemora. Dias depois, descobre que todos os pedidos estão saindo com entrega gratuita. Nenhum valor negativo, nenhuma mensagem de erro, nenhuma interrupção. O sistema funciona com tranquilidade. A conta da transportadora, também.
A situação é fictícia, mas ajuda a entender uma fronteira importante da automação: demonstrar que um programa respeita uma regra não equivale a demonstrar que essa regra representa o que as pessoas precisavam.
Como ler este artigo. Este artigo analisa o anúncio e a documentação pública; não reproduzi a conferência das provas do OSS Verify. A demonstração do frete é fictícia e foi executada pelo assistente de IA em Python, sobre um domínio finito. Ela ilustra a escolha da regra, sem avaliar o Claude ou substituir uma prova formal.
O anúncio de outubro de 2026
Em 22 de outubro de 2026, a Anthropic anunciou uma colaboração com a Theorem sobre verificação formal: demonstração matemática de propriedades definidas de um programa. Relata resultados para 239 pontos de entrada em 123 bibliotecas abertas, sobre código compilado para RISC-V, uma arquitetura de processadores. A equipe situa o trabalho ao longo de algumas semanas, sem datar cada prova. [1]
O recorte envolve hipóteses específicas, incluindo execução em uma única linha de processamento e orçamento fixo de memória. [1] O apêndice delimita entradas menores que 64 MiB — unidade binária de tamanho de dados, equivalente a 67.108.864 bytes. Não se trata de certificar qualquer instalação dessas bibliotecas. [6]
A especificação foi derivada automaticamente dos fuzz tests escritos pelos mantenedores — testes preparados para receber muitas entradas geradas ou modificadas. A propriedade era que o teste compilado nunca travasse, dentro dos limites definidos. As verificações humanas incorporadas ao teste influenciam, portanto, o que a prova cobre. [1]
Os próprios autores reconhecem o limite: verificação formal não significa ausência de todos os bugs, e o verificador não decide se a especificação corresponde à realidade. [1]
O que pode ser conferido publicamente
O repositório OSS Verify consultado em 24 de outubro reúne provas para 60 pontos de entrada em 25 bibliotecas: um subconjunto, não a totalidade anunciada. Informa Rocq 9.2.0, instruções de conferência e os programas exatos a que os resultados se referem. Rocq é uma ferramenta que permite formular teoremas e verificar suas demonstrações por um núcleo certificador. [2][3]
Existe uma diferença entre as fontes: o anúncio diz que os programas sempre terminam normalmente; o README afirma que nenhuma prova daquela versão exclui execução infinita. Para o pacote público, adoto esse contrato mais restrito, sem estendê-lo automaticamente ao restante do trabalho anunciado. [1][2]
O apêndice, nas páginas 1 e 2, explica que um laço infinito silencioso pode deixar de acrescentar eventos ao traço observado — o registro de leituras e escritas. A equivalência desses traços, sozinha, pode confundir travamento com execução infinita. Os autores acrescentam condições de ausência de falhas, mas a enumeração final não declara término explicitamente. [6] O README esclarece que essas provas não excluem execução infinita. [2] Ausência de erro, término e resultado correto continuam sendo perguntas diferentes.
O resultado concreto: encontrar erros difíceis
Segundo o anúncio principal da Anthropic, as tentativas encontraram centenas de bugs. Entre eles, uma falha num descompressor exigia uma entrada rara de cerca de 20 MB; houve também redescoberta da CVE-2026-56132 no libexpat, ligada a dados profundamente aninhados. Ao tentar provar segurança de memória, o Claude também notou uma restrição de arquivos que nem sempre era aplicada, sem provocar travamento. [1] Esse defeito de autorização mostra por que excluir acessos inválidos à memória não basta para garantir que apenas os arquivos permitidos sejam carregados: o comportamento desejado exige outra propriedade.
O tamanho das provas ajuda a entender o esforço
O apêndice informa cerca de 1 bilhão de linhas de Rocq produzidas nas tentativas, das quais 180 milhões integraram provas aceitas. Uma prova típica tinha cerca de 600 mil linhas; o ponto de entrada do cJSON, com 391 linhas, recebeu aproximadamente 630 mil. Na página 3, os autores explicam que só cerca de um décimo dessa prova trata do próprio cJSON: o restante abrange também componentes como inicialização e gerenciamento de memória. [6]
Uma prova pode consumir centenas de milhões de tokens, unidades de texto processadas pelos modelos. [1] Isso dimensiona esforço computacional, não uma fatura. A pergunta prática é escolher propriedades cujo valor justifique esse esforço — e impedir que a busca por uma demonstração destrua a utilidade do programa.
Escrever a prova e conferir a prova
A utilidade de um verificador está em não depender apenas da explicação de quem produziu o resultado. No Rocq, a demonstração precisa ser aceita pelas regras do sistema formal. Uma justificativa convincente em português não ocupa o lugar desse procedimento. A ferramenta permite tanto declarar especificações quanto desenvolver e conferir provas. [3]
Isso muda a maneira de pedir trabalho. Em vez de solicitar apenas “garanta que funciona”, a equipe pode exigir a identificação da propriedade, das condições de validade e do artefato que permite conferi-la. A palavra “garantido” precisa vir acompanhada de um complemento: garantido quanto a quê?
Uma demonstração: tudo verde, frete errado
Vamos definir uma regra comercial simples: abaixo de R$ 200, cobrar R$ 15 de frete; a partir de R$ 200, cobrar zero. Para evitar ambiguidades de arredondamento, usaremos valores inteiros em centavos. O domínio didático inclui todos os valores de zero a R$ 1.000, inclusive: 100.001 entradas possíveis. Não representa um sistema de vendas completo.
Considere duas implementações. A primeira aplica a condição. A segunda sempre devolve zero. Um teste com pedidos de R$ 200, R$ 250 e R$ 1.000 aprova ambas. Os exemplos foram escolhidos deliberadamente dentro da mesma faixa: revelam como uma amostra mal construída deixa de examinar uma parte essencial da regra.
Se acrescentarmos a propriedade “o frete nunca pode ser negativo”, continuaremos aprovando as duas. A versão errada não viola essa propriedade. Ela viola outra exigência: cobrar R$ 15 abaixo do limite. Mais rigor na conferência da primeira frase não conserta a ausência da segunda.
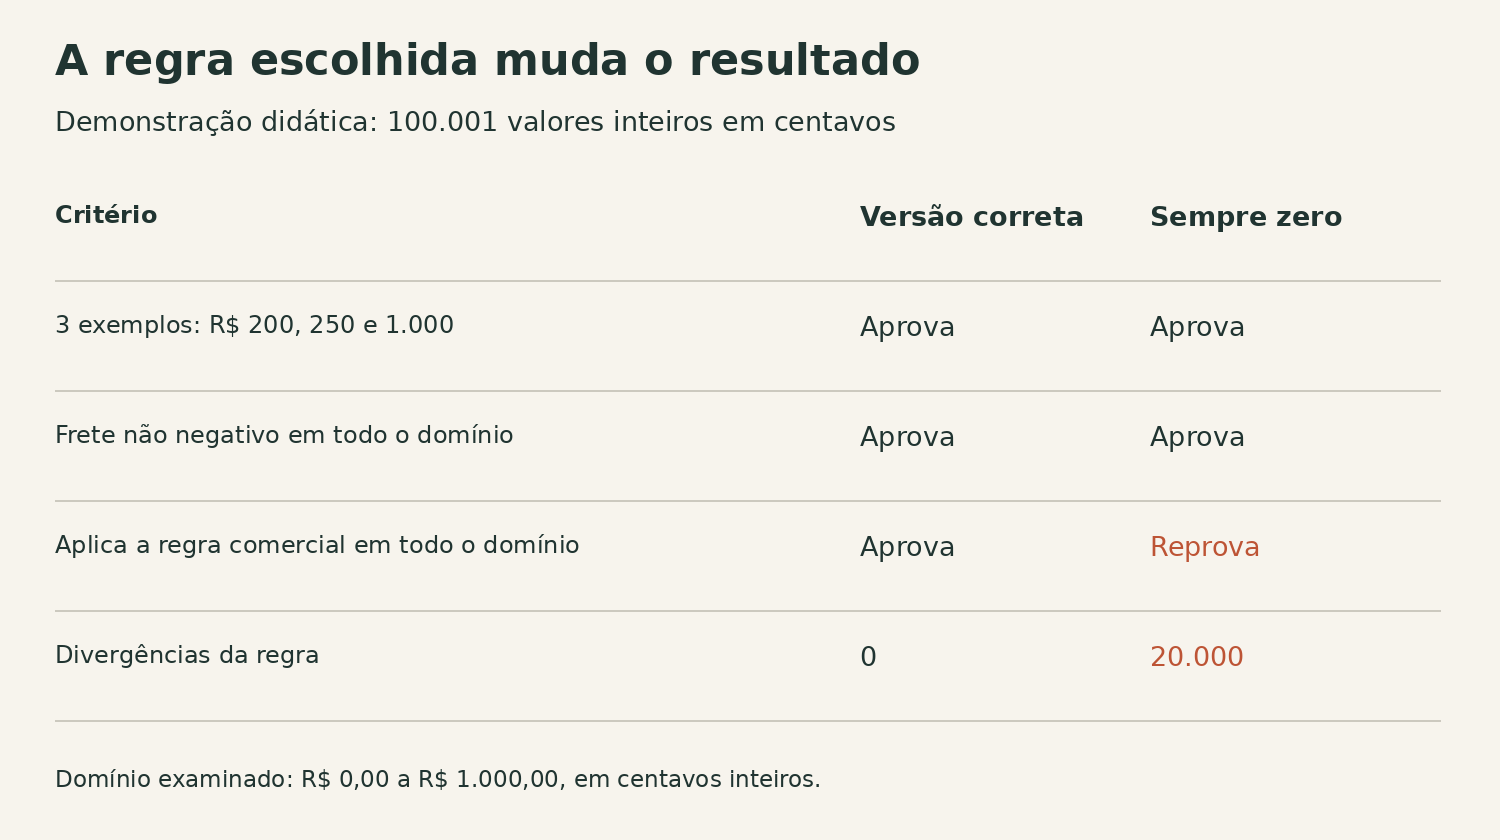
Na enumeração completa desse domínio, a versão correta não apresentou divergências em relação à regra de referência. A versão que sempre entrega zero divergiu em 20.000 entradas, de zero a R$ 199,99. Ambas permaneceram não negativas nas 100.001 entradas.
O resultado cobre cada valor desse conjunto, sem se estender a outros formatos, moedas, valores negativos ou integrações.
Na fronteira, o contraste aparece sem estatística: R$ 199,99 exige R$ 15; R$ 200 exige zero; R$ 200,01 também exige zero. Um único exemplo imediatamente abaixo do limite já revela a versão errada. A qualidade da pergunta pode fazer mais diferença do que multiplicar casos semelhantes.
O risco de mudar o programa para facilitar a prova
A nota 6 do anúncio descreve o risco de reward hacking: satisfazer o critério formal por um atalho que frustra a intenção. O modelo poderia reescrever o programa para que ele trivialmente nunca travasse. Os autores penalizaram correções, deram crédito extra para demonstrar quais entradas eram alteradas e quão poucas eram, e registraram e auditaram as mudanças. [1]
É a ligação com o frete sempre zero: tornar uma propriedade fácil de satisfazer não preserva, por si só, a função desejada. No exemplo, devolver zero resolve a exigência de não negatividade e abandona a cobrança. No desenvolvimento real, é preciso conferir também o comportamento que uma correção modifica.
Uma prova também precisa de endereço
A documentação do OSS Verify vincula suas afirmações a binários específicos, isto é, arquivos executáveis produzidos pela compilação. O pacote usa programas estáticos RISC-V ligados à musl, uma biblioteca básica da linguagem C. O modelo do processo Linux tem limites explícitos. Não é uma garantia sobre qualquer versão executada em outro ambiente. [2]
Para quem contrata software, a aplicação prática é pedir identificação de versão e ambiente. Uma evidência sobre determinado componente não se transfere automaticamente ao sistema que o utiliza, assim como uma inspeção de um elevador não inspeciona toda a estrutura do prédio.
Essa preocupação não nasceu com os modelos de linguagem. O projeto seL4, voltado ao núcleo de um sistema operacional, documenta provas e as hipóteses de que elas dependem, incluindo aspectos de hardware e inicialização. A tradição dos métodos formais já tratava dessas fronteiras. [4]
O trabalho humano muda de lugar
O apêndice acrescenta uma nuance à pergunta do título: os agentes também formulavam especificações intermediárias, com mediana de cerca de 110 linhas, antes de demonstrar a equivalência das versões. [6] Portanto, a IA propunha regras auxiliares; isso reforça a importância de conferir como elas se conectam à exigência original.
Minha leitura é que esse avanço aumenta o valor de formular problemas com precisão. No exemplo do frete, alguém precisa decidir se o limite considera descontos, impostos ou o subtotal. Uma compra de R$ 210 com cupom de R$ 20 tem direito à gratuidade? Sem uma decisão explícita, há pelo menos duas interpretações plausíveis.
A demonstração matemática pode ser rigorosa dentro de uma delas. O conflito comercial continua existindo. Por isso, profissionais de negócio, desenvolvedores e responsáveis pelo atendimento precisam examinar juntos a regra antes de discutir o resultado técnico.
Na educação, o exemplo oferece uma atividade simples: apresentar a regra, mostrar os três testes aprovados e pedir à turma um caso que desfaça a conclusão. Depois, perguntar qual informação ainda falta para lidar com cupons. São propostas didáticas para discutir especificação e limites; não resultados de uma pesquisa sobre aprendizagem.
Cinco perguntas antes de aceitar “foi verificado”
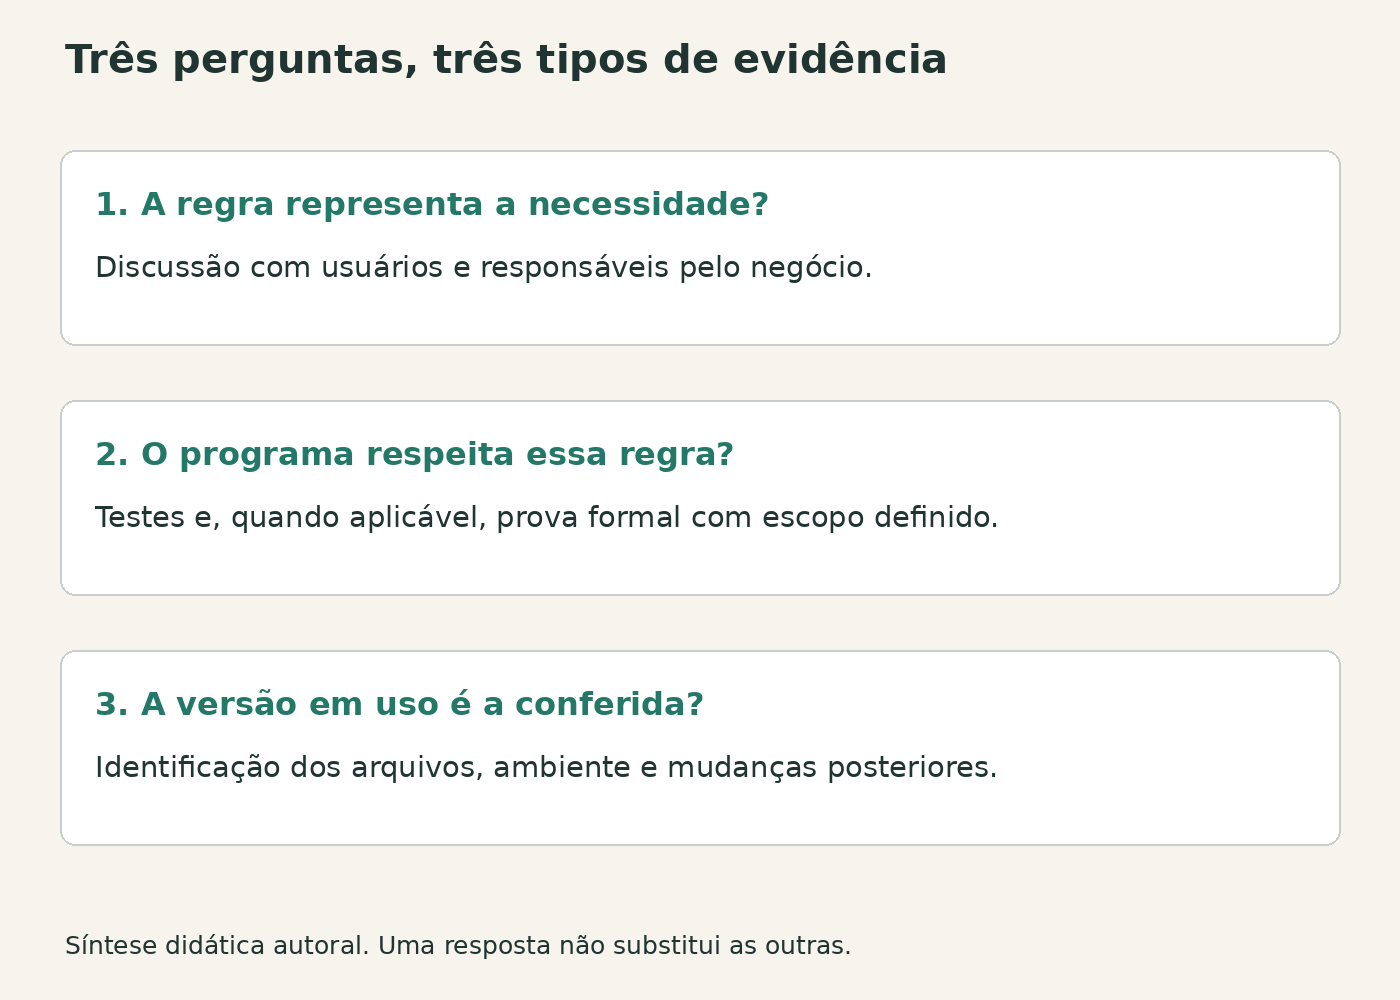
- Qual frase foi demonstrada? Ausência de determinado erro, término da execução ou atendimento à regra de negócio?
- Para quais entradas e condições? O limite inclui a fronteira e as exceções importantes?
- Qual versão foi conferida? Há identificação dos arquivos e do ambiente?
- Como a evidência pode ser reproduzida? Quem realizou essa conferência e o que ficou pendente?
- Quem aprovou a regra? Ela corresponde à necessidade dos usuários e continua válida depois da mudança?
Essas perguntas complementam o guia do site sobre como verificar respostas da inteligência artificial: aqui, o foco é a garantia sobre o comportamento do software, não apenas a conferência de uma resposta textual. [5]
A IA pode ajudar a produzir provas sobre programas. Isso não elimina a necessidade de escolher bem o que será provado. O melhor resultado é juntar duas competências: rigor para conferir a afirmação e responsabilidade para decidir se ela é a afirmação que importa.
Nota técnica e reprodução da demonstração
Execução local pelo assistente de IA: Python 3.12.14. São 100.001 entradas, não 100.001 testes do Claude. Sem rede ou API de modelo. O valor zero integra explicitamente o domínio didático. O código imprime o resultado e verifica as contagens com assert.
SHA-256 de demonstracao.py: 136b6ae30469bb1903083cc76b7351f78cdddb63c8c1ea3183bc058591b23a71
import json
import platform

def frete_correto(total_centavos):
    return 0 if total_centavos >= 20_000 else 1_500

def frete_errado(total_centavos):
    return 0

dominio = range(100_001)  # Inteiros de 0 a R$ 1.000,00, inclusive.
amostra = [20_000, 25_000, 100_000]
resultado = {'python': platform.python_version(), 'entradas': len(dominio), 'amostra': amostra, 'modelos': {}}
for nome, funcao in [('correto', frete_correto), ('errado', frete_errado)]:
    falhas = [v for v in dominio if funcao(v) != frete_correto(v)]
    resultado['modelos'][nome] = {
        'passa_amostra': all(funcao(v) == frete_correto(v) for v in amostra),
        'sempre_nao_negativo_no_dominio': all(funcao(v) >= 0 for v in dominio),
        'divergencias_regra': len(falhas),
        'primeira_divergencia': falhas[0] if falhas else None,
        'ultima_divergencia': falhas[-1] if falhas else None,
        'casos_limite': {str(v): funcao(v) for v in [19_999, 20_000, 20_001]}
    }
assert resultado['modelos']['errado']['divergencias_regra'] == 20_000
assert resultado['modelos']['correto']['divergencias_regra'] == 0
print(json.dumps(resultado, ensure_ascii=False, indent=2))
Referências
1. Keane Lucas e colaboradores. LLMs are making formal software verification feasible at a much larger scale. Anthropic, 22/10/2026. https://www.anthropic.com/research/formal-verification
2. Theorem Labs. OSS Verify: proofs about OSS-Fuzz fuzz targets. README e instruções, versão consultada em 24/10/2026. https://github.com/theorem-labs/oss-verify-proofs
3. The Rocq Team. About The Rocq Prover. Documentação institucional, consultada em 24/10/2026. https://rocq-prover.org/about
4. seL4. Verification. Documentação do projeto, consultada em 24/10/2026. https://sel4.systems/Verification/
5. Gilmar Barros. Como verificar respostas da inteligência artificial antes de usá-las no trabalho. Consultado em 24/10/2026. https://gilmarbarros.com.br/como-verificar-respostas-inteligencia-artificial/
6. Anthropic. Appendix: LLMs are making formal software verification feasible at a much larger scale. 22/10/2026, páginas 1–4; consultado em 24/10/2026. https://www-cdn.anthropic.com/files/4zrzovbb/website/6867eadf760258fa8b42a504600cd3c036d16358.pdf
Quer receber mais guias práticos sobre IA e trabalho?
Assine a newsletter e receba conteúdos objetivos para aplicar no trabalho e na carreira.
Quero receber os conteúdos
Mestre em Educação Profissional e Tecnológica, engenheiro de software e profissional de transformação digital. Produz conteúdos sobre inteligência artificial, carreira e desenvolvimento pessoal e profissional.