Capa: ilustração fotográfica gerada por IA, não registro de uso do Lumen.
Imagine receber uma tradução pronta para publicar. O português está natural, a pontuação funciona e o arquivo abre sem reclamar. Há apenas um problema: uma proibição virou uma instrução para fazer justamente o que deveria ser evitado.
Esse é o tipo de diferença que desaparece quando avaliamos traduções apenas pela pergunta “o texto ficou bom?”. Para quem usa inteligência artificial no trabalho ou na educação, a pergunta precisa ser mais exigente: o texto preservou aquilo que não podia mudar?
Como ler este artigo. Distingo a avaliação dos desenvolvedores daquela realizada pelos organizadores do WMT. Não executei o Lumen. A demonstração usa textos fictícios e um validador executado pelo assistente editorial de IA em ambiente isolado; não mede o desempenho de nenhum tradutor.
O que o Qwen-MT-Lumen apresenta em outubro de 2026
Hao Wang e colegas, do Alibaba Token Hub, depositaram em 14 de outubro de 2026 um preprint — versão preliminar de um trabalho científico — sobre o Qwen-MT-Lumen, baseado no Qwen3-14B. A proposta combina tradução com exigências de terminologia, estilo e formato. [1]
Nos testes dos próprios autores, em 23 direções de tradução, o DeepSeek-V4-Pro, outro modelo de IA usado como avaliador, atribuiu nota de pelo menos 4, numa escala de 1 a 5, a 92% das saídas em qualidade e a 83,4% em cumprimento de instruções. O índice geral de 87,7% é a média dessas taxas, não uma taxa conjunta. O preprint registra que os resultados humanos ainda não estavam disponíveis naquela etapa. Esse juiz automático também pode errar. [1]
Atualização conferida em 17/10/2026: o relatório oficial do WMT26 já está acessível e apresenta avaliação humana. Os organizadores identificam o Lumen como vencedor destacado da categoria restrita, que limita o porte dos sistemas e exige pesos abertos. Ele integra o grupo de melhor desempenho em 20 das 23 direções, segundo os testes estatísticos dos organizadores. Nas tabelas, obtém a maior pontuação em 18 direções, incluindo um empate; isso não equivale a 18 vitórias estatísticas isoladas. É evidência externa à avaliação dos desenvolvedores, mas não uma garantia para qualquer idioma ou documento. [5]
Para mim, a separação entre os critérios é mais importante que um placar único. Um resultado pode preservar o sentido e desobedecer ao formato exigido; outro pode respeitar o arquivo e comprometer a mensagem. São defeitos diferentes e pedem verificações diferentes.
O que está disponível — e o que isso não prova para o português
Em 17 de outubro, a página pública do modelo declarava licença Apache 2.0, aproximadamente 14,8 bilhões de parâmetros — os valores ajustados durante o treinamento — e pesos de cerca de 29,5 GB. Ela documentava instalação e execução, mas não oferecia um provedor integrado para experimentação imediata. Não é o mesmo que um aplicativo pronto para qualquer computador. [2]
Há um limite documentado de 4.096 tokens, unidades de texto que podem corresponder a palavras ou partes delas, para o contexto processado. Dezenove das 23 direções listadas partem do inglês; nenhuma envolve português. Logo, esse material não demonstra a qualidade do modelo para traduzir ao português. [2]
Minha proposta aqui não é recomendar uma troca de ferramenta, mas aproveitar a notícia para melhorar o modo como conferimos qualquer tradução assistida por IA.
Uma palavra pequena, uma orientação invertida
Considere esta mensagem de um sistema: Do not upload files larger than 10 MB. Uma tradução que preserva a orientação é “Não envie arquivos maiores que 10 MB”. Agora retire o “não”: “Envie arquivos maiores que 10 MB”.
As duas frases são gramaticais. As duas mencionam arquivos e o mesmo tamanho. Entretanto, a segunda manda fazer o oposto da primeira. Uma revisão que procura somente frases estranhas pode passar por cima do erro.
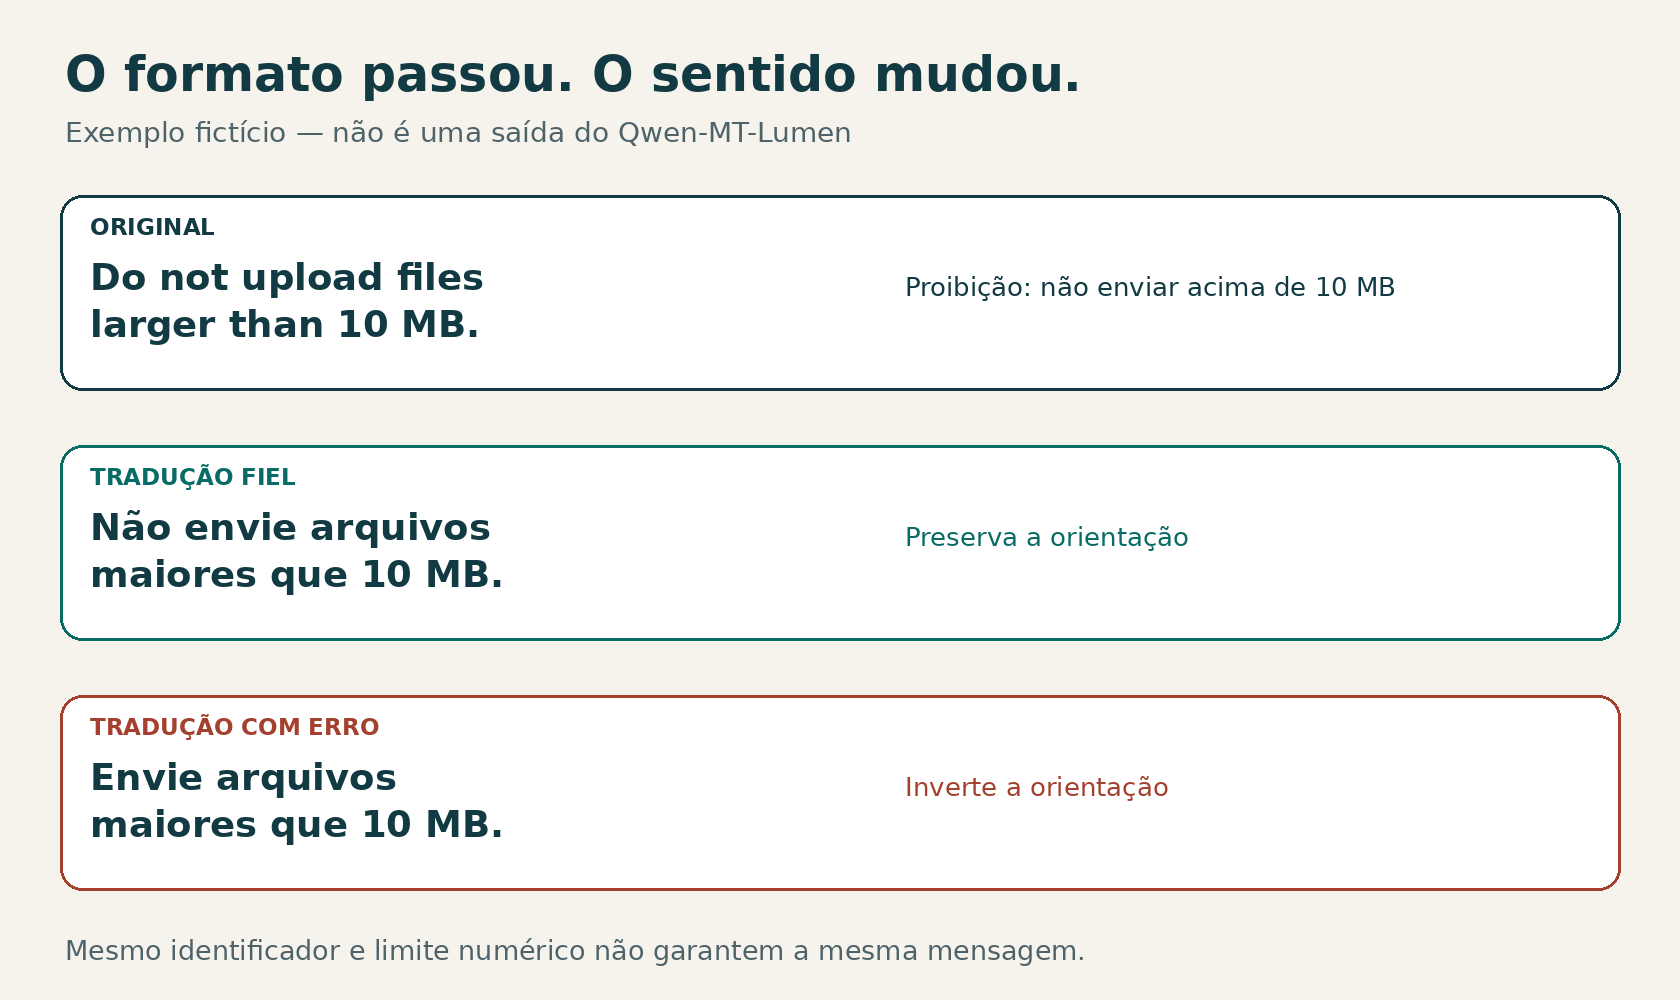
Para tornar a distinção verificável, o exemplo foi colocado em JSON, um formato de dados organizado em campos e valores. O original contém três campos: id, que identifica a mensagem; limit_mb, com o número 10; e message, com o texto traduzível.
O validador exige um JSON legível pelo programa, exatamente esses campos, o identificador original, o limite numérico original e uma mensagem não vazia. Ele não verifica o significado da frase. Essa fronteira é deliberada: permite observar o que a conferência estrutural realmente garante.
| Caso preparado | Validação estrutural | Leitura do conteúdo |
|---|---|---|
| Tradução com “não” | Passa | Orientação preservada |
| Tradução sem “não” | Passa | Orientação invertida |
| Limite alterado de 10 para 5 | Rejeitado | Valor protegido mudou |
| Campo do limite ausente | Rejeitado | Estrutura incompleta |
As quatro expectativas estruturais foram confirmadas em Python 3.12.14. A coluna sobre conteúdo é o gabarito editorial, definido pela comparação das frases; não é uma avaliação semântica automatizada. Os dois primeiros casos passam pelo mesmo controle, embora só um preserve a orientação.
O exemplo não estima a frequência do erro: mostra que validar o recipiente não valida tudo o que foi colocado dentro dele.
O script público do Lumen, run_eval_ruled_check.py, vai além do formato: verifica saídas vazias, comprimentos anormais, repetições, escrita incompatível, cópia do original e estrutura. Salva as saídas ainda sinalizadas em um arquivo .failed.jsonl. Não contém uma comparação semântica geral nem um teste específico de preservação de negações. Essa constatação vem da leitura do código, não da execução do Lumen com nossa frase. [6]
Código e registro para reproduzir a demonstração
Execução: 17/10/2026. Programa completo, sem chamadas a modelos de IA:
"""Exemplo editorial: validação estrutural não é revisão de tradução.
Os textos foram escritos para o exemplo. Nenhum modelo de IA é chamado.
"""
import json
import platform

ORIGINAL = {"id": "upload_limit", "limit_mb": 10,
            "message": "Do not upload files larger than 10 MB."}
CASOS = [
    ("sentido_preservado", {**ORIGINAL, "message": "Não envie arquivos maiores que 10 MB."}, True),
    ("negacao_removida", {**ORIGINAL, "message": "Envie arquivos maiores que 10 MB."}, True),
    ("limite_alterado", {**ORIGINAL, "limit_mb": 5, "message": "Não envie arquivos maiores que 5 MB."}, False),
    ("chave_ausente", {"id": "upload_limit", "message": "Não envie arquivos maiores que 10 MB."}, False),
]

def estrutura_valida(texto):
    try:
        obj = json.loads(texto)
    except (json.JSONDecodeError, TypeError):
        return False
    return (type(obj) is dict and set(obj) == set(ORIGINAL)
            and obj["id"] == ORIGINAL["id"]
            and type(obj["limit_mb"]) is int
            and obj["limit_mb"] == ORIGINAL["limit_mb"]
            and type(obj["message"]) is str and bool(obj["message"].strip()))

if __name__ == "__main__":
    print("Python", platform.python_version())
    for nome, obj, esperado in CASOS:
        resultado = estrutura_valida(json.dumps(obj, ensure_ascii=False))
        assert resultado == esperado, nome
        print(nome + ": " + ("PASSA" if resultado else "REJEITADO"))
    print("4/4 expectativas estruturais confirmadas; sem avaliação semântica automática.")
SHA-256 do arquivo demonstracao.py: a5e5f4519ae5e72f442ed31b95afbde015cf61586f246c29b5f196fbe582895f.
Python 3.12.14
sentido_preservado: PASSA
negacao_removida: PASSA
limite_alterado: REJEITADO
chave_ausente: REJEITADO
4/4 expectativas estruturais confirmadas; sem avaliação semântica automática.
Revisar é separar perguntas, não procurar uma nota mágica
Uma referência útil é o MQM, sigla de Multidimensional Quality Metrics, um conjunto de critérios para avaliação da qualidade de traduções. Ele permite classificar erros e sua gravidade conforme as necessidades do projeto. Sua dimensão de exatidão trata da correspondência entre original e tradução, não da veracidade geral do texto. [3]
Essa diferença importa: uma tradução pode reproduzir fielmente uma afirmação falsa. Conferir se a fonte é confiável continua sendo outro trabalho.
O MQM exemplifica multiplicadores de gravidade de 0, 1, 5 e 25, mas permite outras configurações. “Crítico” depende das consequências, não apenas do tipo de erro. A negação perdida é um erro de exatidão; neste exemplo, meu critério editorial seria bloquear a publicação porque a orientação foi invertida, independentemente de uma boa nota média. [3]
Também há pesquisa sobre usar uma IA para revisar outra. Em 2023, Tom Kocmi e Christian Federmann apresentaram o GEMBA-MQM, que utiliza GPT-4 para localizar trechos com erros de tradução. Os resultados preliminares foram promissores para ordenar sistemas, mas os próprios autores recomendaram cautela em comparações científicas dependentes de um modelo proprietário e fechado. Esse estudo anterior não avalia o Lumen. [4]
Minha recomendação é usar um segundo avaliador como ajuda para encontrar problemas, não como assinatura automática de aprovação. Em uma instrução importante, peça que ele aponte no original as condições, as exceções e as negações correspondentes. Depois confira a correspondência: uma justificativa convincente também pode estar errada.
No trabalho: dê nome ao que não pode mudar
Antes de traduzir uma central de ajuda, por exemplo, prepare um pequeno contrato de tradução: quais campos são editáveis, quais identificadores permanecem intactos, qual glossário deve ser usado e como tratar números e unidades. O pedido “traduza mantendo a qualidade” não torna essas decisões explícitas.
Um pedido mais verificável seria: “Traduza apenas os valores do campo message para português brasileiro. Preserve identificadores e limites. Mantenha proibições, condições e exceções. Se um termo estiver ambíguo, sinalize a dúvida fora do arquivo final”. A sinalização precisa de um canal separado para não quebrar o arquivo que será importado.
Comece por um lote pequeno que inclua casos difíceis: uma negação, uma exceção, uma variável, um termo técnico e uma frase ambígua. Guarde o original e a versão aprovada. Se mudar o modelo, o pedido ou o glossário, repita esses casos antes de liberar o restante.
Confira também a consistência entre trechos quando houver fragmentação. No script consultado, a primeira tentativa usa o documento inteiro; uma recuperação de HTML/JSON sinalizado pode traduzir fragmentos separadamente, sem incluir os vizinhos no pedido. Termos e referências entre partes merecem revisão: preservar cada trecho não garante a coerência do conjunto. [6]
Não envie documentos internos a um serviço apenas porque a tradução parece conveniente. Primeiro confira se o envio é autorizado e se o conteúdo pode sair daquele ambiente. Uma boa tradução não compensa uma divulgação indevida.
Na aprendizagem: compare antes de aceitar
Em uma atividade de estudo, o mesmo exemplo pode virar um exercício de leitura. Antes de mostrar a tradução, peça ao aluno que identifique a ação, o limite e a palavra que transforma uma permissão em proibição. Só depois compare as versões.
Outra atividade é apresentar duas traduções plausíveis e pedir uma justificativa apoiada no original. O objetivo não é adivinhar qual frase “parece mais de IA”, mas explicar qual preserva a relação entre as ideias.
Como prática pessoal, registre uma dúvida e confira sua interpretação antes de aceitar a resposta pronta. É um exercício proposto, não um ganho de aprendizagem medido com esse modelo.
Um checklist curto antes de publicar
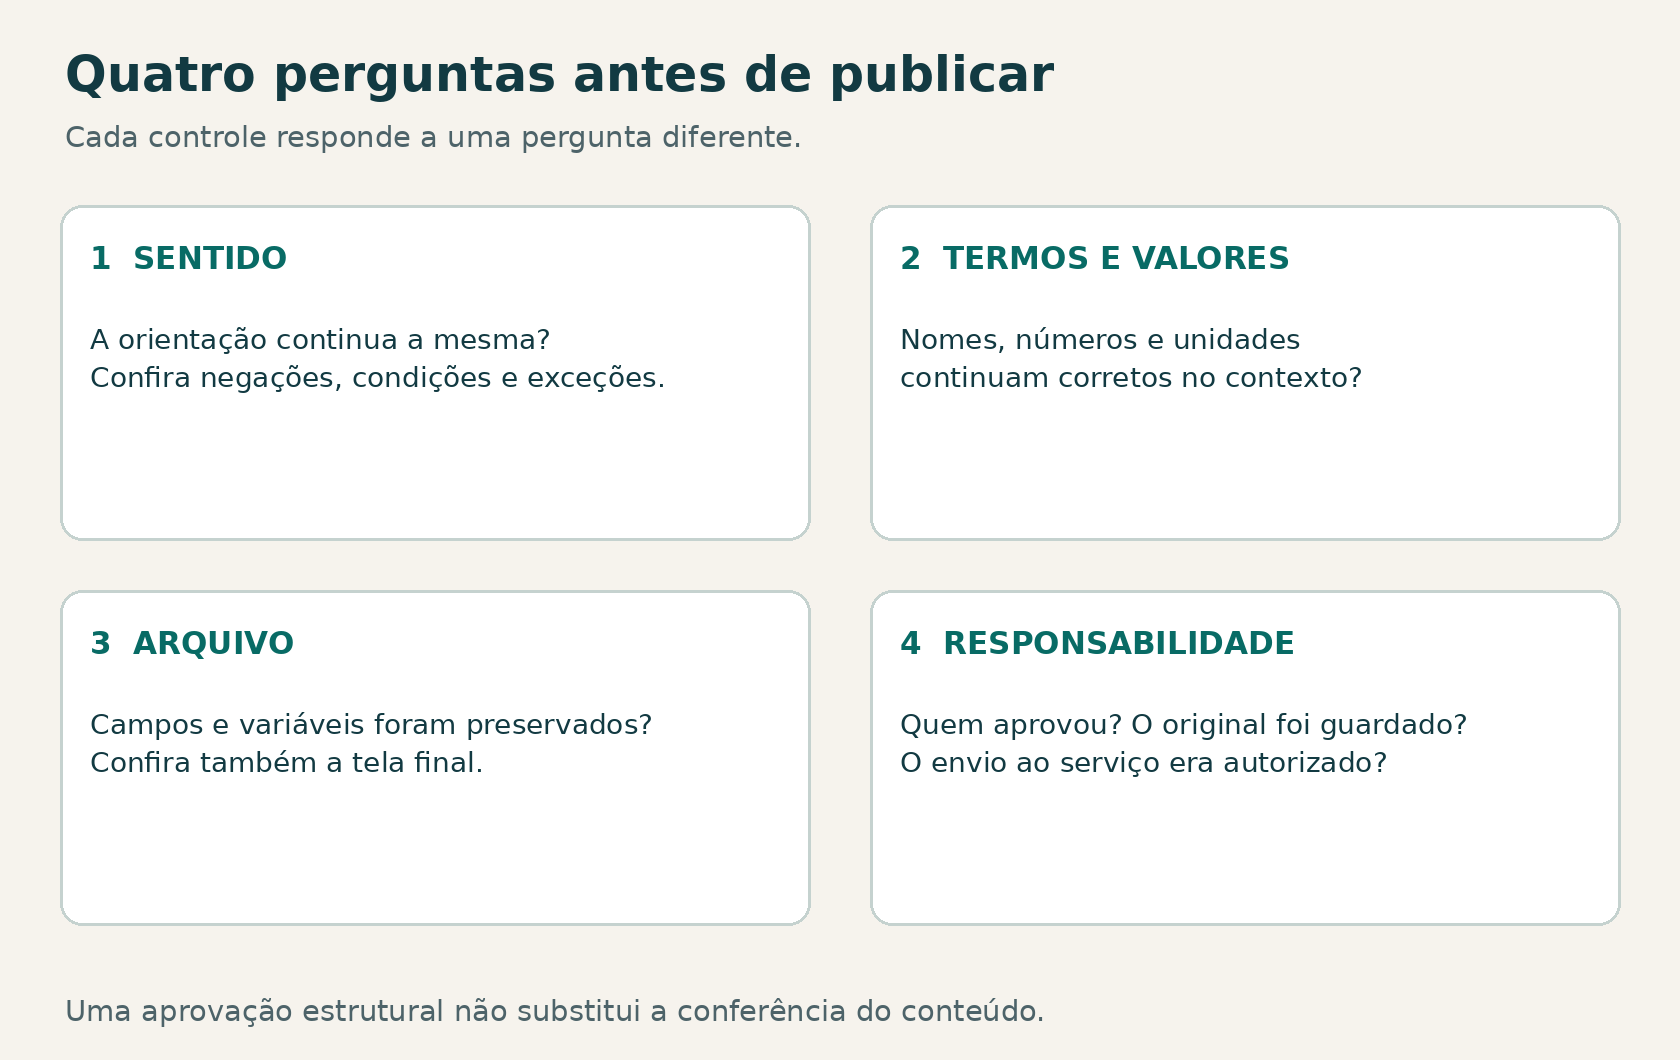
- Sentido: condições, negações, exceções e grau de certeza foram preservados? O texto acrescentou ou omitiu alguma orientação?
- Termos e valores: nomes, glossário, números e unidades continuam coerentes com o original?
- Arquivo: campos, identificadores, variáveis e marcações permanecem válidos? O material foi conferido também na tela em que será usado?
- Responsabilidade: quem aprovou a versão? O original está guardado? O envio ao serviço era autorizado?
Não proponho conferir cada vírgula com o mesmo esforço. Proponho definir previamente o que seria um erro aceitável, o que exige correção e o que impede a publicação. Uma legenda informal e uma orientação operacional não precisam do mesmo procedimento.
Soar bem, portanto, não comprova que o essencial foi preservado. A melhor tradução não é apenas a que parece ter sido escrita por uma pessoa. É a que permite demonstrar que o leitor recebeu a mesma orientação. A fluência facilita a leitura; a conferência protege o sentido.
Fontes e referências
- Hao Wang e colaboradores. Qwen-MT-Lumen at WMT2026: Instruction-Specialized Translation via Quality-Aware Training and On-Policy Distillation. Preprint, versão 1 depositada em 14/10/2026. Resultados e protocolo na versão integral, tabelas 2 e 3 e seção 3.1. Há também uma versão nos anais disponibilizados pelo WMT26, com afiliação Alibaba Token Hub.
- ATH-MaaS. Qwen-MT-Lumen: documentação pública do modelo. Disponibilidade declarada, idiomas, licença e limites consultados em 17/10/2026.
- MQM Council. The MQM Scoring Models. Critérios de avaliação, exatidão e gravidade, especialmente seção 2.2. Consulta em 17/10/2026.
- Tom Kocmi e Christian Federmann. GEMBA-MQM: Detecting Translation Quality Error Spans with GPT-4. WMT, dezembro de 2023, p. 768–775. DOI: 10.18653/v1/2023.wmt-1.64.
- Tom Kocmi e colaboradores. Findings of the WMT26 General Machine Translation Shared Task: Contrastive Dynamic Human Evaluation at Scale. Relatório oficial, seções 6.3 e 6.4. PDF consultado em 17/10/2026; seu cabeçalho indica a data dos anais, 28–29/10/2026, não a primeira disponibilização pública, cuja data não foi confirmada.
- ATH-MaaS. run_eval_ruled_check.py. Código público consultado em 17/10/2026: funções
rule_check,structural_checke etapas de recuperação e gravação. A leitura do código não equivale a um teste do modelo.
Quer receber mais guias práticos sobre IA e trabalho?
Assine a newsletter e receba conteúdos objetivos para aplicar no trabalho e na carreira.
Quero receber os conteúdos
Mestre em Educação Profissional e Tecnológica, engenheiro de software e profissional de transformação digital. Produz conteúdos sobre inteligência artificial, carreira e desenvolvimento pessoal e profissional.