Um modelo pode acertar os exemplos que recebeu e falhar diante de situações novas. O avanço do aprendizado de máquina tornou os dados, os critérios de avaliação e a comparação entre métodos parte central da própria tecnologia.
Imagine preparar uma prova e entregar aos estudantes exatamente as mesmas perguntas usadas em um exercício resolvido, com a mesma ordem e os mesmos valores. Um bom desempenho pode revelar memória ou domínio do procedimento. A prova, sozinha, não distingue bem as duas coisas.
Algo semelhante ocorre quando avaliamos um modelo apenas nos exemplos utilizados para ajustá-lo. Precisamos investigar se o aprendizado ajuda em situações diferentes daquelas que participaram do ajuste.
Dados não são uma matéria-prima sem escolhas
Um conjunto de dados resulta de decisões. Alguém define o que será coletado, quais casos entram, como serão representados e quais respostas serão consideradas corretas. Mesmo quando a coleta é automatizada, as escolhas não desaparecem: passam a fazer parte do procedimento.
Considere mensagens de atendimento classificadas por assunto. Se apenas os casos resolvidos forem incluídos, o conjunto pode deixar de fora justamente os mais difíceis. Se duas equipes usam critérios diferentes, o mesmo texto pode receber rótulos distintos. Antes de culpar o algoritmo, é necessário entender como o material foi produzido.
O livro Deep Learning apresenta a distinção entre desempenho no treinamento e generalização para novos exemplos como um fundamento do aprendizado de máquina. Generalizar é manter uma capacidade útil fora dos casos específicos usados no ajuste, dentro de condições que precisam ser examinadas. [1]
Treinamento, validação e teste têm funções diferentes
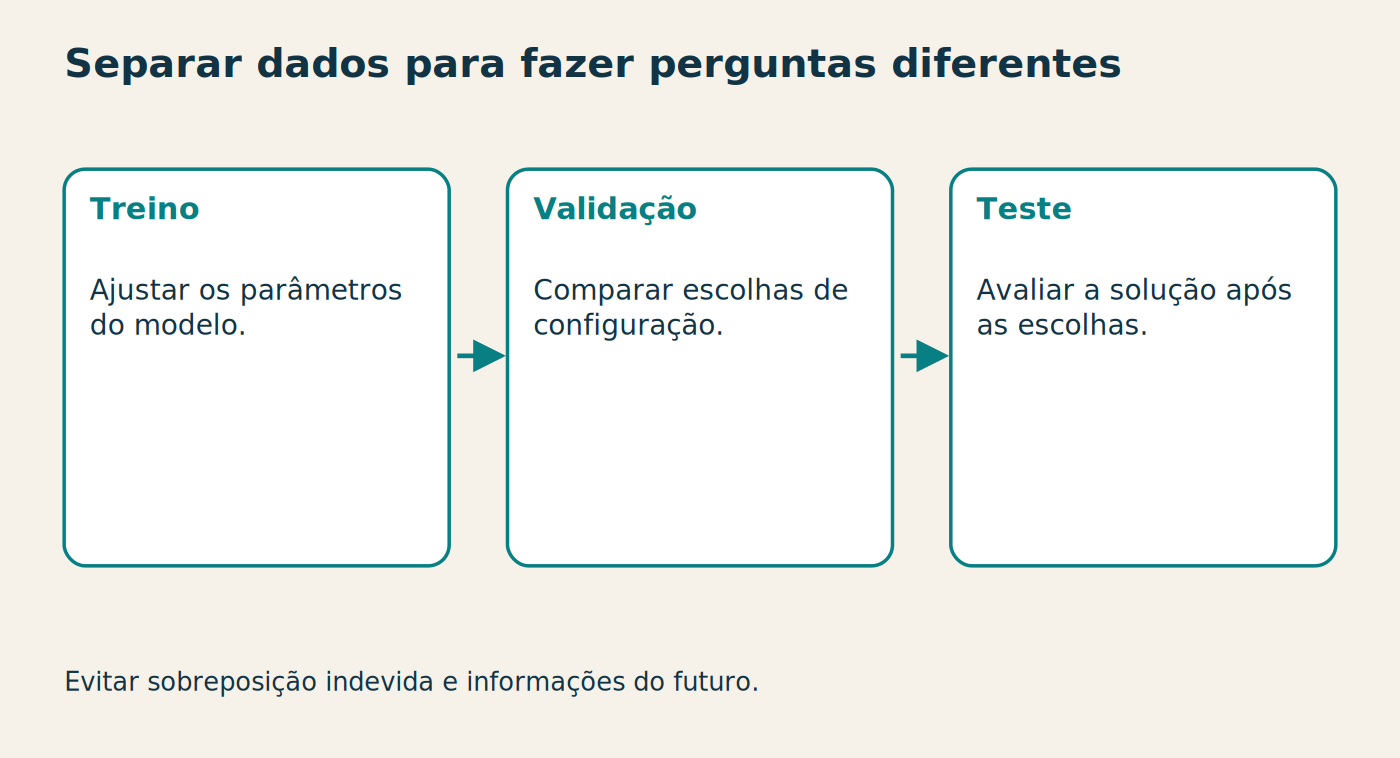
Uma organização comum separa exemplos para ajustar o modelo, orientar escolhas durante o desenvolvimento e realizar uma avaliação final. Os nomes mais usados são treinamento, validação e teste. A separação deve respeitar a estrutura dos dados, não apenas sortear linhas sem pensar. [1]
Se duas versões quase idênticas de um documento aparecem em grupos diferentes, o teste pode ficar artificialmente fácil. Se estamos prevendo eventos futuros, usar informações que só existiriam depois do evento também distorce a avaliação.
Chamamos de vazamento de dados a presença, no desenvolvimento ou na avaliação, de informação que não estaria legitimamente disponível no uso pretendido. O nome sugere um acidente, mas o problema pode surgir de uma decisão aparentemente inocente de preparação.
Uma nota alta pode esconder o erro importante
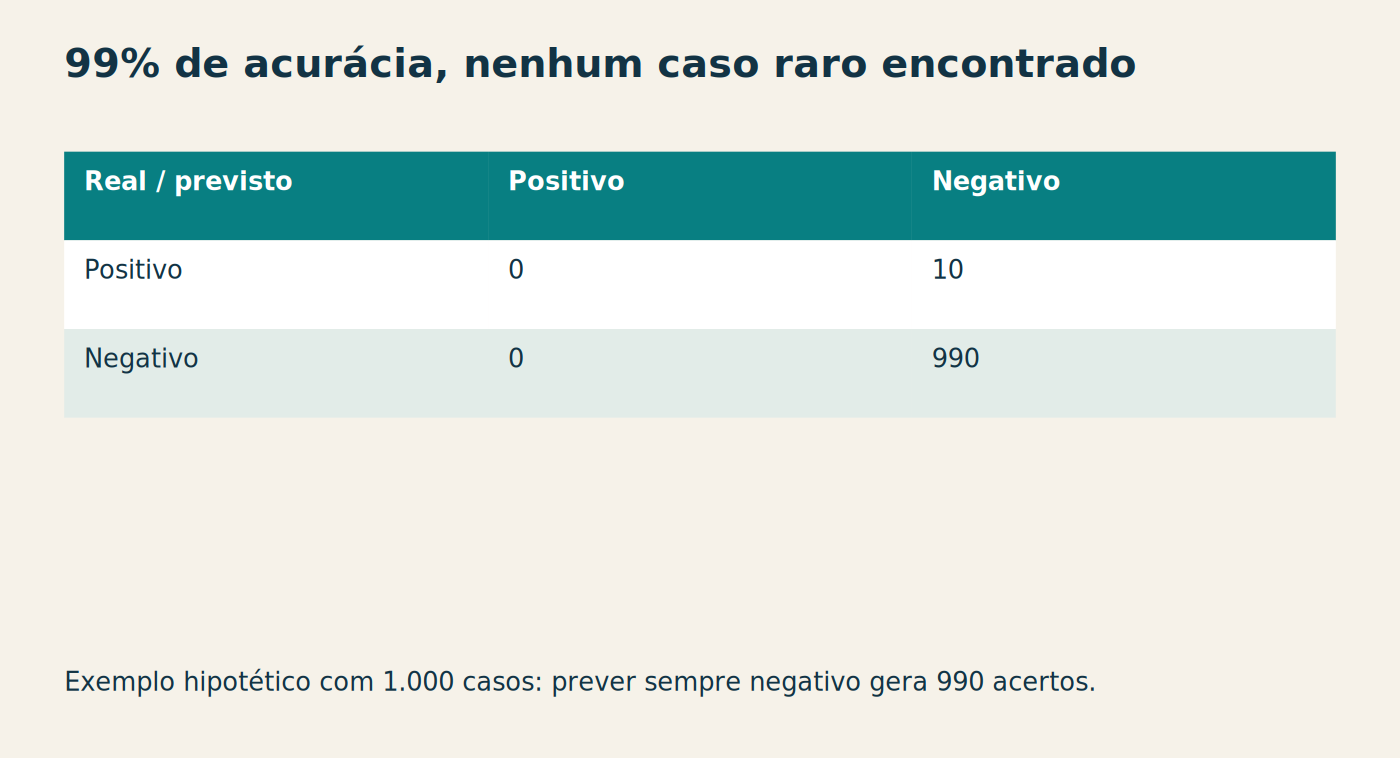
Considere mil itens, dos quais dez apresentam uma falha que queremos detectar. Um sistema que sempre responde “sem falha” acerta 990 itens. Sua acurácia é de 99%, mas ele não encontra nenhuma das dez ocorrências relevantes.
Nesse exemplo hipotético, a medida agregada se afasta da finalidade da tarefa. Acurácia é a proporção total de classificações corretas. Em situações desequilibradas, precisamos examinar também quantas ocorrências foram encontradas e quantos alertas eram indevidos.
Precisão, nesse contexto técnico, mede a proporção de alertas positivos que correspondem a casos positivos reais. Revocação, também chamada sensibilidade em certos contextos, mede a proporção dos casos positivos reais que foi identificada. Nenhuma medida decide sozinha qual troca entre erros é aceitável.
ImageNet e a infraestrutura para comparar modelos
Em 2009, Jia Deng e colaboradores apresentaram ImageNet, uma base de imagens organizada em uma estrutura hierárquica de categorias. O projeto ajudou a criar condições para treinar e comparar métodos de reconhecimento visual em maior escala. [2]
O desafio ILSVRC, documentado posteriormente por Olga Russakovsky e colaboradores, organizou tarefas, conjuntos de dados e critérios de avaliação compartilhados. Isso permitia comparar sistemas sob condições definidas, em vez de depender apenas de demonstrações escolhidas por cada equipe. [3]
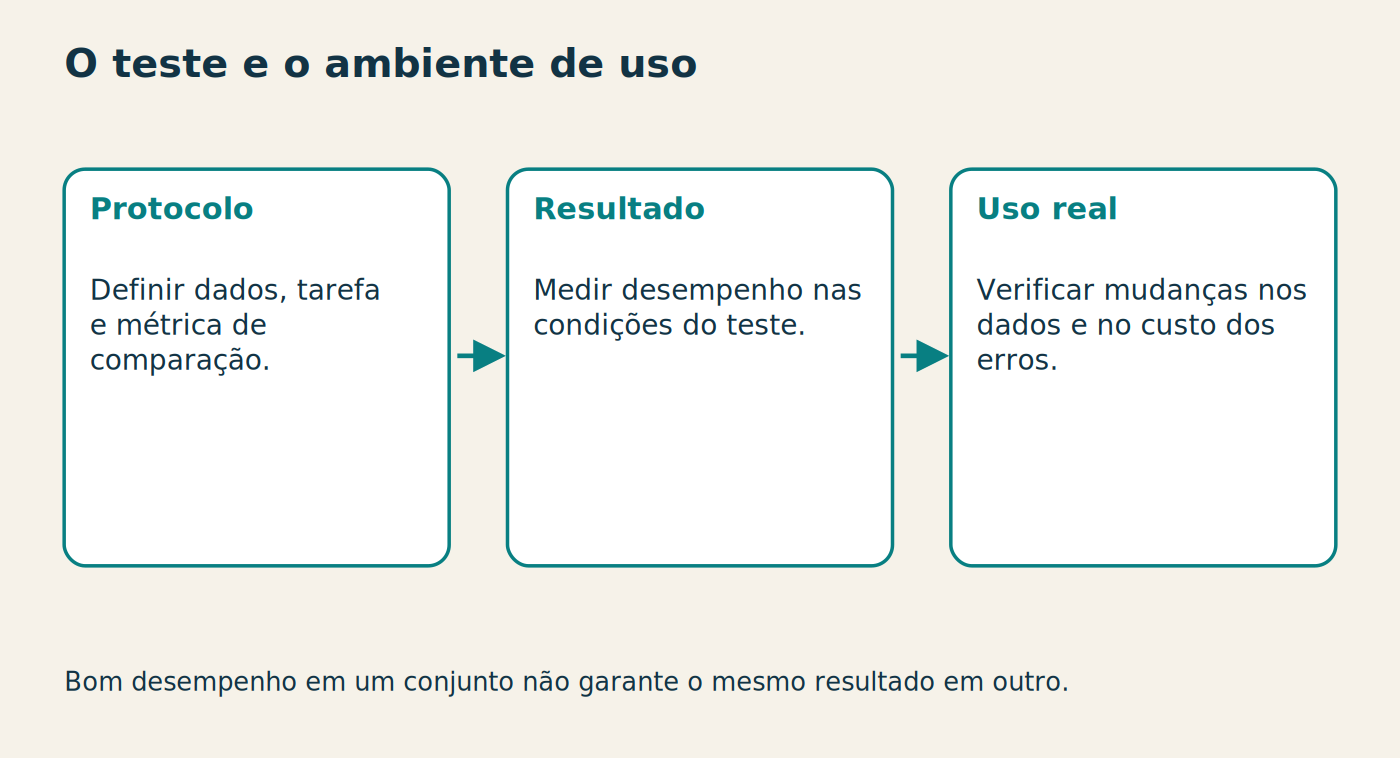
A base define categorias e condições particulares. Ganhar uma competição fornece evidência importante sobre aquele protocolo; a passagem ao uso real exige avaliar outras câmeras, contextos e distribuições.
O que um benchmark faz
Um benchmark é uma referência de avaliação com tarefas e medidas definidas. Ele ajuda a observar progresso e comparar alternativas. Seu valor depende da qualidade do protocolo e da relação com as capacidades que pretendemos estudar.
Imagine comparar dois sistemas de leitura de documentos. Se um teste usa apenas páginas nítidas e o outro inclui fotografias inclinadas, as notas não são diretamente equivalentes. Mesmo usando o mesmo conjunto, podemos ter objetivos diferentes: reconhecer caracteres, extrair campos ou responder perguntas sobre o conteúdo.
O benchmark precisa ser descrito junto com o resultado. Uma pontuação solta perde parte de seu significado. Também é útil examinar se melhorias no teste se mantêm em novos dados, evitando transformar a avaliação em um alvo que passa a substituir a tarefa original.
Mais dados podem ampliar qual padrão?
Se um conjunto contém uma distorção sistemática, acrescentar mais exemplos semelhantes pode reforçá-la. Quantidade não substitui cobertura, qualidade dos registros ou adequação das categorias. A pergunta é quais variações precisam estar representadas para o uso previsto.
No exemplo de mensagens, talvez faltem pedidos escritos de maneira informal, textos curtos ou solicitações com mais de um assunto. Em imagens, pode haver pouca variedade de iluminação ou de fundo. Identificar essas lacunas exige conhecer a tarefa, não apenas o tamanho do arquivo.
Também existe trabalho humano por trás dos rótulos. Pessoas interpretam, classificam, corrigem e decidem casos difíceis. A expressão “o modelo aprendeu com os dados” pode esconder essa contribuição se tratarmos o conjunto como algo que surgiu pronto.
Mudanças no mundo podem alterar o desempenho
Um sistema treinado em uma situação pode receber dados diferentes depois da implantação. Produtos mudam, vocabulários se transformam, sensores são substituídos e usuários encontram novas maneiras de interagir. Essa mudança na distribuição dos dados pode reduzir a utilidade de um modelo antes satisfatório.
A avaliação, portanto, continua depois do lançamento. Acompanhar erros relevantes ajuda a reconhecer quando o ambiente se afasta das condições do teste e a decidir se é necessário investigar os dados, ajustar o processo ou retreinar o modelo.
Uma referência simples ajuda. Se uma regra antiga, uma busca convencional ou o processo manual continua resolvendo melhor certos casos, o projeto precisa considerar essa evidência. A comparação ajuda a escolher a solução que melhor atende à tarefa.
O que muda na nossa leitura da história
Ao colocar os dados no centro, a história da IA deixa de ser apenas uma sequência de algoritmos brilhantes. Passamos a enxergar coleções, categorias, infraestrutura de avaliação e trabalho de preparação como parte do avanço técnico.
No próximo capítulo, veremos como redes com múltiplas camadas ganharam destaque em tarefas visuais. O resultado dependeria da combinação entre métodos, dados e capacidade computacional. A interação entre esses elementos será o centro da explicação.