Reconhecer uma imagem exige lidar com variações de posição, iluminação, escala e contexto. Redes com múltiplas camadas ganharam destaque ao aprender transformações úteis dos dados, combinando métodos de treinamento, grandes conjuntos de exemplos e capacidade computacional.
Uma criança aponta para uma bicicleta em uma fotografia. Para quem olha, a identificação pode parecer imediata. Para um sistema, a imagem chega como uma representação numérica. A bicicleta pode estar inclinada, parcialmente escondida ou fotografada de longe. Escrever uma regra que cubra todas essas variações é difícil.
O desafio não é apenas calcular mais rápido. É construir uma representação que preserve o que importa para a tarefa e tolere mudanças que não deveriam alterar a resposta. Esse problema ajuda a compreender por que o aprendizado de representações se tornou tão relevante.
O que torna uma rede “profunda”
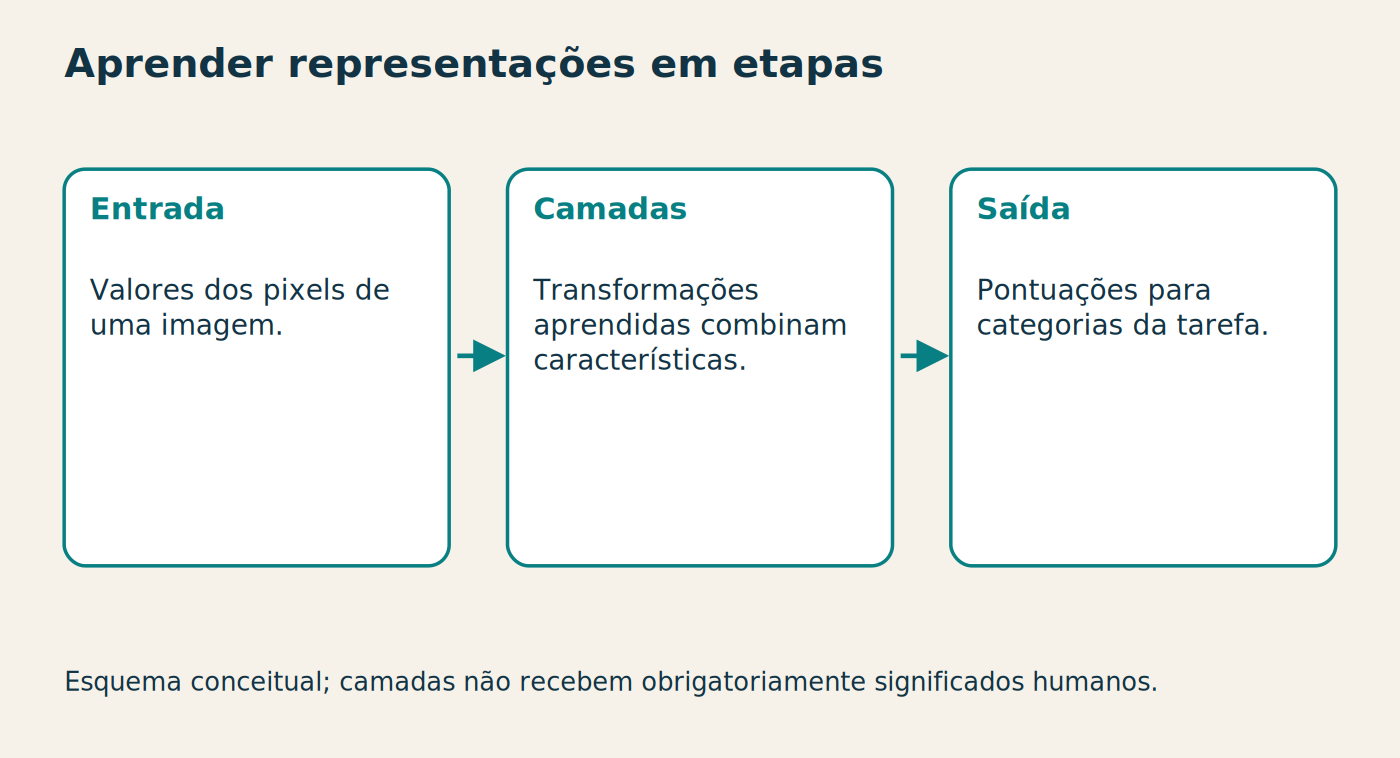
Uma rede neural transforma entradas por meio de unidades e parâmetros organizados em camadas. Em redes profundas, há múltiplas etapas de transformação entre a entrada e a saída. O termo descreve a composição do modelo; não mede profundidade de pensamento ou compreensão humana. [1]
Em uma explicação visual simplificada, etapas iniciais podem responder a padrões locais, enquanto combinações posteriores participam da representação de estruturas mais complexas. Essa imagem é útil para introduzir o tema, mas não significa que toda rede contenha uma sequência fixa de “bordas, peças e objetos” facilmente interpretável.
Representação, aqui, é uma forma numérica de organizar características relevantes. Durante o treinamento, a rede pode ajustar transformações que tornam certas diferenças mais úteis para a tarefa. Em vez de depender apenas de características escolhidas manualmente, parte dessa construção passa a ser aprendida.
O treinamento precisa saber em que direção ajustar
Suponha que a rede receba uma imagem e produza pontuações para categorias. Uma função de perda mede a discrepância entre a saída e o objetivo de treinamento. O procedimento de otimização usa informações sobre essa perda para modificar parâmetros.
O artigo de David Rumelhart, Geoffrey Hinton e Ronald Williams, de 1986, tornou-se um marco na divulgação da retropropagação de erros para aprender representações em redes. Retropropagação é um modo de calcular como mudanças nos parâmetros influenciam a perda, propagando essa informação pelas operações do modelo. [2]
A palavra “erro” não indica que a rede ficou constrangida ou compreendeu uma falha. Refere-se a uma quantidade definida no treinamento. A qualidade do ajuste depende de como o objetivo foi formulado e de quais dados o representam.
Convolução: procurar padrões locais com parâmetros compartilhados
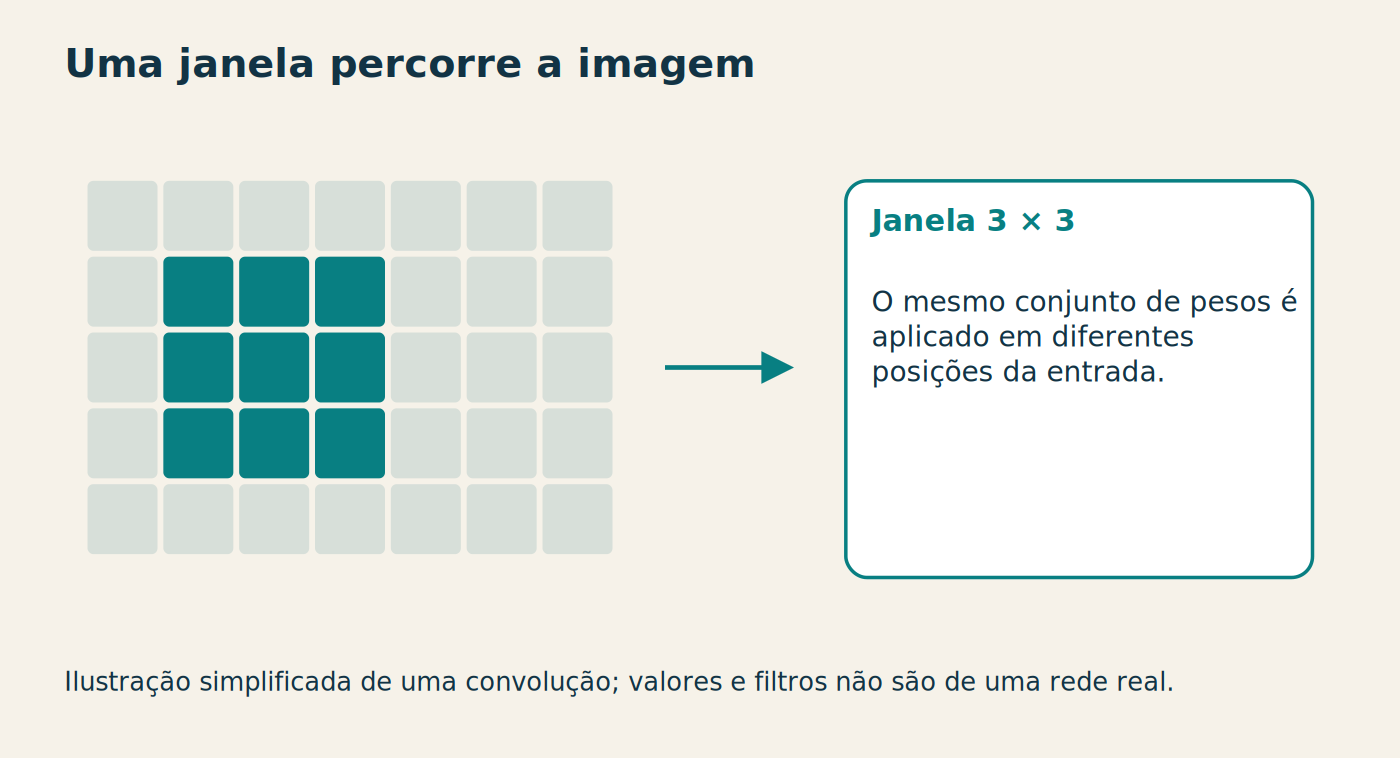
Redes convolucionais usam operações que examinam regiões locais e compartilham parâmetros entre posições. Para uma imagem, isso permite aplicar um mesmo tipo de detector a diferentes regiões, em vez de criar uma regra independente para cada posição. [1]
Imagine uma pequena janela percorrendo uma grade de pixels. Em cada posição, a operação combina valores daquela região. O resultado forma outra representação. Repetir e combinar essas transformações permite construir um processamento mais complexo.
O desenho é uma simplificação de uma operação numérica. Não há uma pequena pessoa olhando a janela, e reconhecer um padrão local não equivale a compreender a cena inteira. A utilidade precisa aparecer no desempenho da tarefa escolhida.
O marco de 2012
Em 2012, Alex Krizhevsky, Ilya Sutskever e Geoffrey Hinton apresentaram uma rede convolucional profunda para classificação de imagens do ImageNet. O trabalho, associado ao nome AlexNet, combinou arquitetura, treinamento e implementação eficiente em GPUs, tornando-se um marco do período. [3]
Uma GPU é um processador adequado a muitas operações paralelas, originalmente associado ao processamento gráfico. Certos cálculos usados em redes podem aproveitar esse paralelismo. Isso não significa que qualquer tarefa se acelere igualmente ou que o hardware substitua a necessidade de um método adequado.
A história fica incompleta quando atribuímos tudo a um único fator. Havia dados organizados, um protocolo de comparação, técnicas de treinamento e recursos computacionais. A combinação alterou o que era viável demonstrar em uma tarefa importante.
Classificar uma foto não esgota a visão
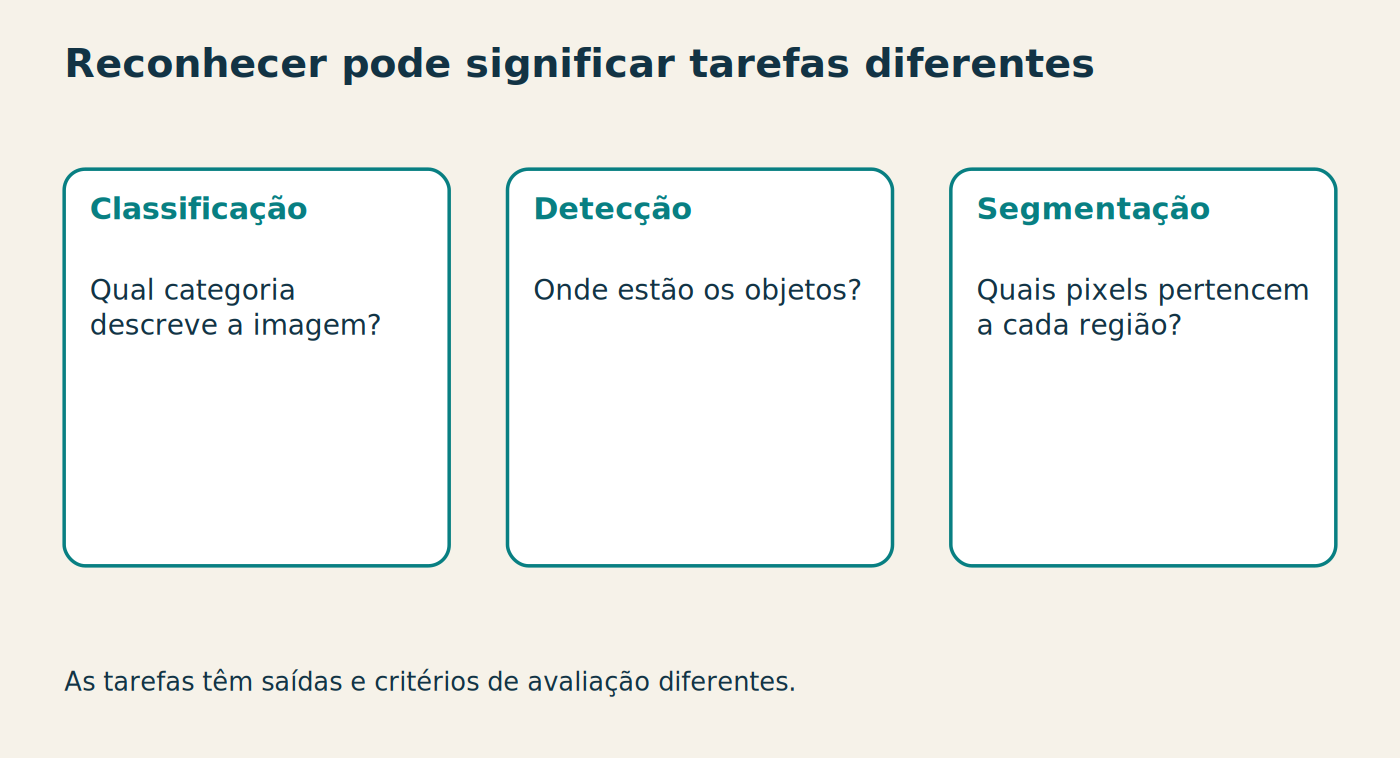
Classificação atribui uma categoria a uma entrada. Detecção procura também localizar objetos. Segmentação pode atribuir categorias a regiões ou pixels. Essas tarefas usam critérios e saídas diferentes, mesmo quando compartilham componentes.
Um sistema que informa “bicicleta” pode não dizer onde ela está. Outro pode localizá-la e ainda não reconhecer que uma parte está quebrada. Uma pergunta sobre segurança de uso exige informações e critérios que vão além da presença do objeto.
Essa distinção evita que uma nota em reconhecimento visual seja tratada como prova de compreensão completa de imagens. O ganho pode ser expressivo e, ao mesmo tempo, delimitado.
Aprender um atalho continua sendo possível
Imagine que quase todas as bicicletas de um conjunto estejam fotografadas em ruas e quase todos os barcos, sobre água. Um modelo pode usar o fundo como uma pista forte. Quando recebe uma bicicleta dentro de uma loja ou um barco fora d’água, a relação muda.
O exemplo é hipotético. Sua função é mostrar que uma rede pode explorar regularidades disponíveis sem selecionar automaticamente aquelas que consideramos essenciais. A quantidade de camadas não garante que a representação coincida com nossas categorias explicativas.
Para investigar isso, podemos variar fundos, condições de captura e exemplos, além de analisar erros. A avaliação precisa acompanhar a diversidade do uso previsto. Um resultado agregado pode ocultar falhas concentradas em situações específicas.
Reutilizar representações aprendidas
Uma rede treinada em uma coleção pode servir de ponto de partida para outra tarefa relacionada. Essa ideia, conhecida como transferência de aprendizagem, permite aproveitar representações já ajustadas e adaptá-las a novas condições. O benefício depende da relação entre os problemas e da forma de adaptação. [4]
Não é uma transferência automática de competência universal. Um conjunto pequeno e particular pode exigir avaliação cuidadosa; diferenças de domínio podem reduzir o ganho. O modelo inicial oferece uma possibilidade de reaproveitamento, não uma dispensa de testes.
Também existe uma distinção entre usar a rede para produzir uma saída e continuar seu treinamento. A primeira atividade aplica parâmetros existentes; a segunda modifica esses parâmetros. Essa diferença reaparecerá quando discutirmos modelos de linguagem e o uso de contexto.
Uma mudança de representação, com continuidade histórica
As redes profundas retomaram questões que vimos nos neurônios artificiais e no perceptron, mas em condições e arquiteturas diferentes. O avanço envolveu aprender representações úteis em múltiplas etapas e tornar seu treinamento viável em tarefas relevantes.
Isso não apagou regras, busca ou conhecimento de domínio. Sistemas podem combinar componentes aprendidos com procedimentos explícitos. A contribuição histórica é ampliar o repertório, não substituir toda engenharia por um único método.
No próximo capítulo, veremos outra forma de aprendizagem. Em vez de receber apenas exemplos com respostas esperadas, um sistema pode agir em um ambiente e usar consequências para ajustar seu comportamento. Jogos oferecem um laboratório especialmente claro para estudar essa relação.