Produzir texto exige relacionar partes de uma sequência. A arquitetura Transformer, apresentada em 2017, ofereceu uma maneira influente de realizar esse processamento. Para entender seu impacto, precisamos separar tokens, atenção, treinamento e geração.
Leia a frase: “Na margem do rio, havia um banco de areia”. Agora pense na palavra banco em uma mensagem sobre um pagamento. A mesma forma escrita participa de sentidos diferentes. O contexto ajuda a interpretar relações que uma lista isolada de palavras não captura.
Esse problema não começou com os chatbots. Tradução, reconhecimento de fala e outros trabalhos com linguagem já exigiam modelos de sequências. O Transformer aparece nessa história como uma arquitetura específica, construída sobre pesquisas anteriores, e não como o surgimento repentino de toda a linguagem computacional.
O artigo de 2017
Ashish Vaswani e sete coautores apresentaram Attention Is All You Need em 2017. O trabalho propôs o Transformer e avaliou sua aplicação em tradução automática. A arquitetura utilizava mecanismos de atenção e dispensava recorrência na construção proposta, permitindo maior paralelismo durante o treinamento. [1]
Arquitetura é a organização das operações e componentes de um modelo. Ela define como as representações são transformadas e relacionadas. O artigo original descrevia um sistema com codificador e decodificador; modelos posteriores adotaram diferentes organizações, incluindo variantes baseadas em apenas um desses lados.
Portanto, “Transformer” e “assistente conversacional” não são sinônimos. Uma arquitetura pode participar de sistemas com objetivos diferentes. O produto que recebe mensagens e responde envolve outras decisões de treinamento, interface e integração.
Antes da resposta, o texto é representado
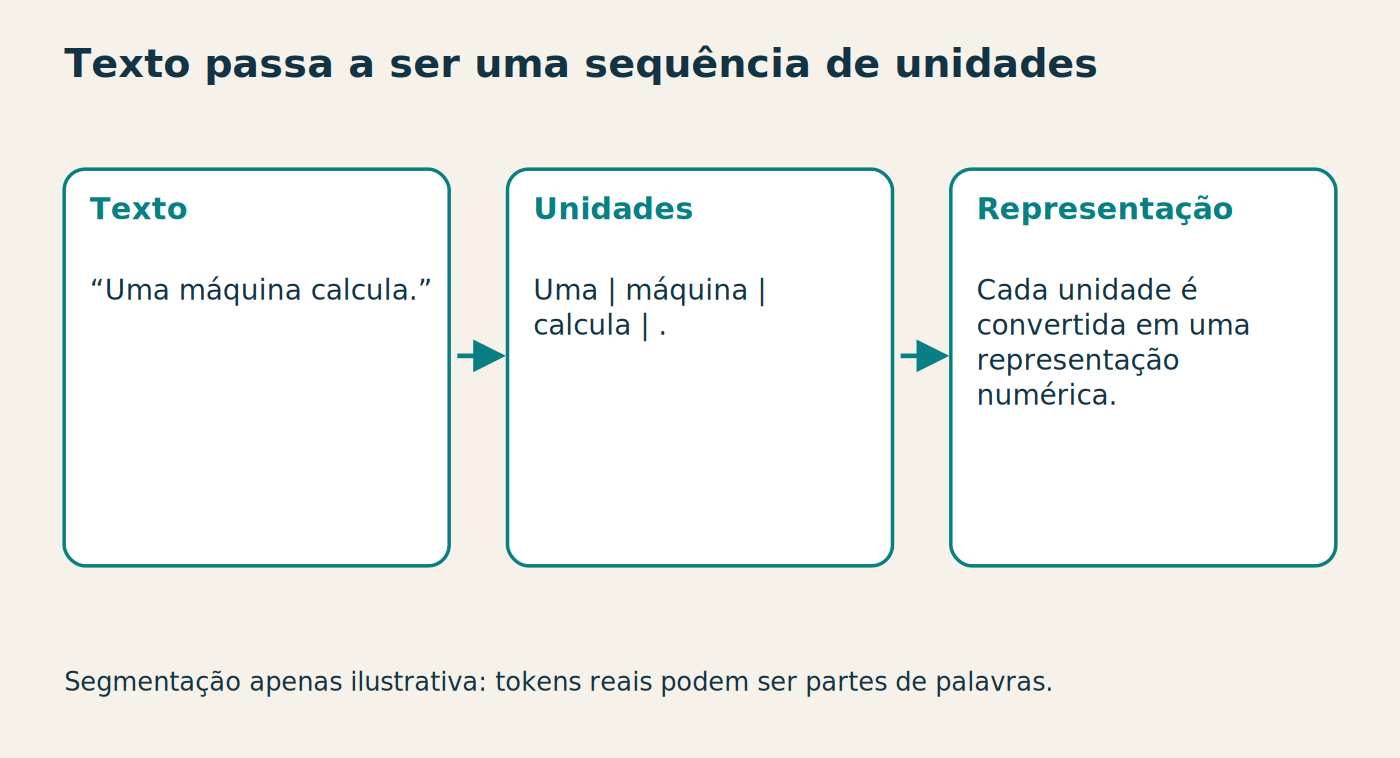
Um modelo normalmente não recebe palavras como objetos humanos prontos. O texto é convertido em unidades chamadas tokens e, depois, em representações numéricas. Um token pode corresponder a uma palavra, parte de palavra, sinal ou outra unidade definida pelo tokenizador.
O tokenizador é o componente que realiza essa divisão e associação. A mesma frase pode ser dividida de maneiras diferentes conforme o sistema. Por isso, uma ilustração com palavras separadas é didática; não deve ser anunciada como a tokenização exata de qualquer modelo.
Essa distinção tem consequências práticas. Comprimento em palavras e comprimento em tokens não são medidas idênticas. Um limite de contexto expresso em tokens não corresponde a um número fixo de páginas ou frases em todos os idiomas e formatos.
Atenção é uma operação matemática
Em termos simplificados, um mecanismo de atenção calcula como combinar representações de elementos disponíveis no contexto. Os pesos dessa combinação dependem dos dados e dos parâmetros aprendidos. A palavra não descreve interesse consciente ou esforço subjetivo. [1]
Podemos ilustrar relações entre “banco”, “rio” e “areia”, mas não devemos fingir que uma linha desenhada corresponde a pesos medidos de um modelo real. Uma figura didática explica a ideia de relacionar elementos. Inspecionar uma rede específica exige dados e métodos próprios.
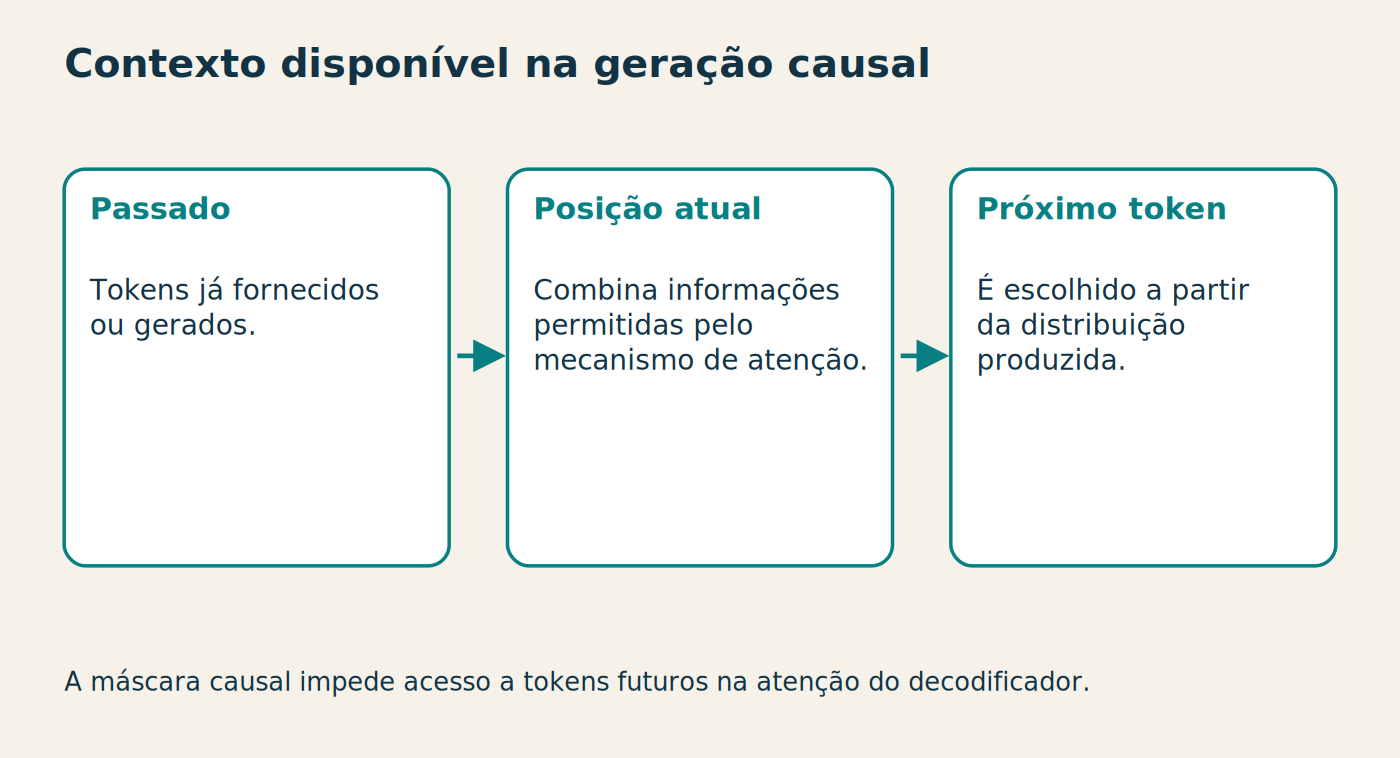
Também importa distinguir contextos de acesso. Em modelos autoregressivos usados para gerar texto, a previsão de um próximo token utiliza os elementos anteriores disponíveis; ela não consulta livremente os tokens futuros que ainda não foram gerados. Outras arquiteturas, como codificadores bidirecionais, têm condições diferentes.
Treinar e gerar são momentos distintos
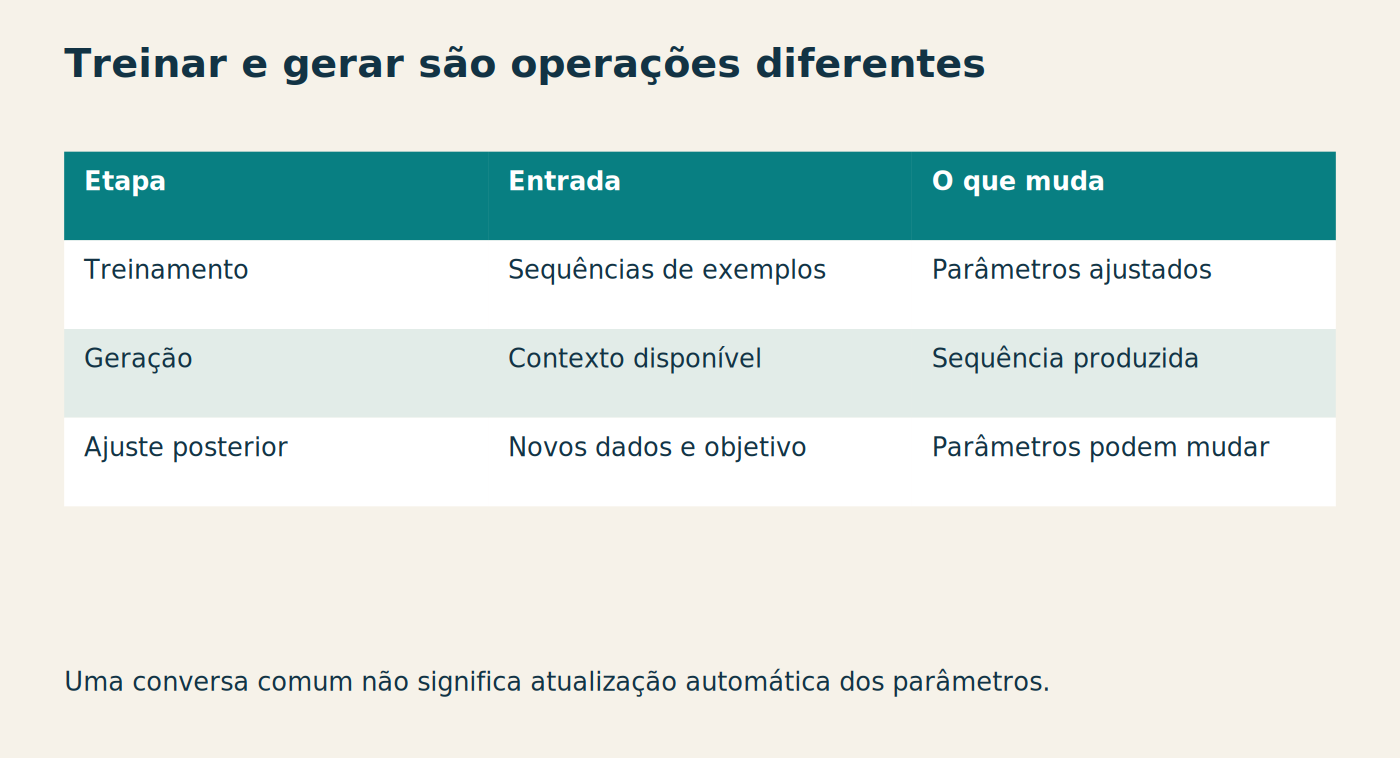
Durante o treinamento, parâmetros são ajustados segundo objetivos definidos. Em muitos modelos de linguagem autoregressivos, um objetivo central é prever o próximo token a partir de uma sequência. Repetido em grande escala, esse processo pode produzir representações úteis para diversas tarefas. [2]
Na geração, o modelo usa parâmetros já ajustados e o contexto recebido para calcular possibilidades de continuação. Uma estratégia de seleção escolhe o próximo token; o processo se repete. O contexto vai incluindo o que já foi produzido.
Fornecer um documento durante uma conversa não significa necessariamente modificar permanentemente os parâmetros. O sistema pode usar o documento como contexto naquela interação. Retreinamento, ajuste adicional e consulta a informações externas são operações diferentes.
Prever continuação pode sustentar tarefas complexas
A expressão “próximo token” parece pequena diante de um texto longo, de um resumo ou de um trecho de código. Mas uma tarefa de treinamento simples de formular pode exigir representações de muitas regularidades para ser executada bem.
Isso não autoriza concluir que toda resposta resulta de compreensão humana, nem que o sistema apenas copia frases inteiras de uma lista. O comportamento precisa ser investigado em tarefas concretas. Modelos podem combinar padrões de maneiras úteis e também produzir erros difíceis de perceber.
O trabalho sobre GPT-3, publicado em 2020 por Tom Brown e colaboradores, investigou a realização de diferentes tarefas a partir de instruções e exemplos no contexto. Os resultados ajudaram a ampliar o interesse por modelos de linguagem de grande escala, com limites que o próprio artigo discutia. [2]
Fluência e verdade seguem critérios diferentes
Uma continuação pode ser linguisticamente plausível e conter uma data inventada. Se o objetivo é responder a uma pergunta factual, o critério de sucesso precisa incluir correspondência com evidências, não apenas naturalidade do texto.
Imagine pedir o título de um artigo que não existe. Uma resposta com autores, revista e ano pode parecer convincente por imitar a forma de uma referência acadêmica. A estrutura correta não comprova que o documento foi publicado.
No próximo capítulo, veremos como consulta a fontes e uso de ferramentas podem ajudar em tarefas desse tipo. Essas integrações acrescentam possibilidades de verificação, mas também introduzem suas próprias falhas. O resultado precisa ser conferido no nível da tarefa completa.
Instruções mais claras ajudam a definir o trabalho
Um prompt é o conteúdo fornecido para orientar uma interação, incluindo pedido e contexto. Se você deseja um resumo para iniciantes, informar público, extensão e finalidade reduz ambiguidades sobre a saída desejada.
Uma instrução clara não concede ao modelo informação que não foi fornecida nem garante correção. Se o documento não contém uma data, pedir “responda com precisão” não cria essa evidência. Pode ser mais útil solicitar que o sistema identifique o que está ausente e indique os trechos usados.
Também é importante definir a atividade: reescrever um texto, resumir um documento, formular hipóteses e verificar fatos exigem critérios diferentes. Quanto mais claramente distinguimos essas tarefas, melhor conseguimos avaliar a ajuda recebida.
A arquitetura não encerra a história
O Transformer tornou-se uma contribuição central para muitos modelos, mas não representa toda a IA. Os capítulos anteriores continuam relevantes: dados, objetivos, regras, busca, avaliação e interfaces participam dos sistemas que usamos.
O último capítulo reúne essas camadas. Veremos como um modelo de linguagem pode ser integrado a fontes e ferramentas para formar um assistente, e por que produzir uma resposta, consultar uma informação e concluir uma ação são capacidades que precisam ser distinguidas.