Em algumas tarefas, a resposta certa não chega pronta para cada situação. O sistema age, observa consequências e procura melhorar uma estratégia. O aprendizado por reforço estuda essa relação entre ação, ambiente e recompensa.
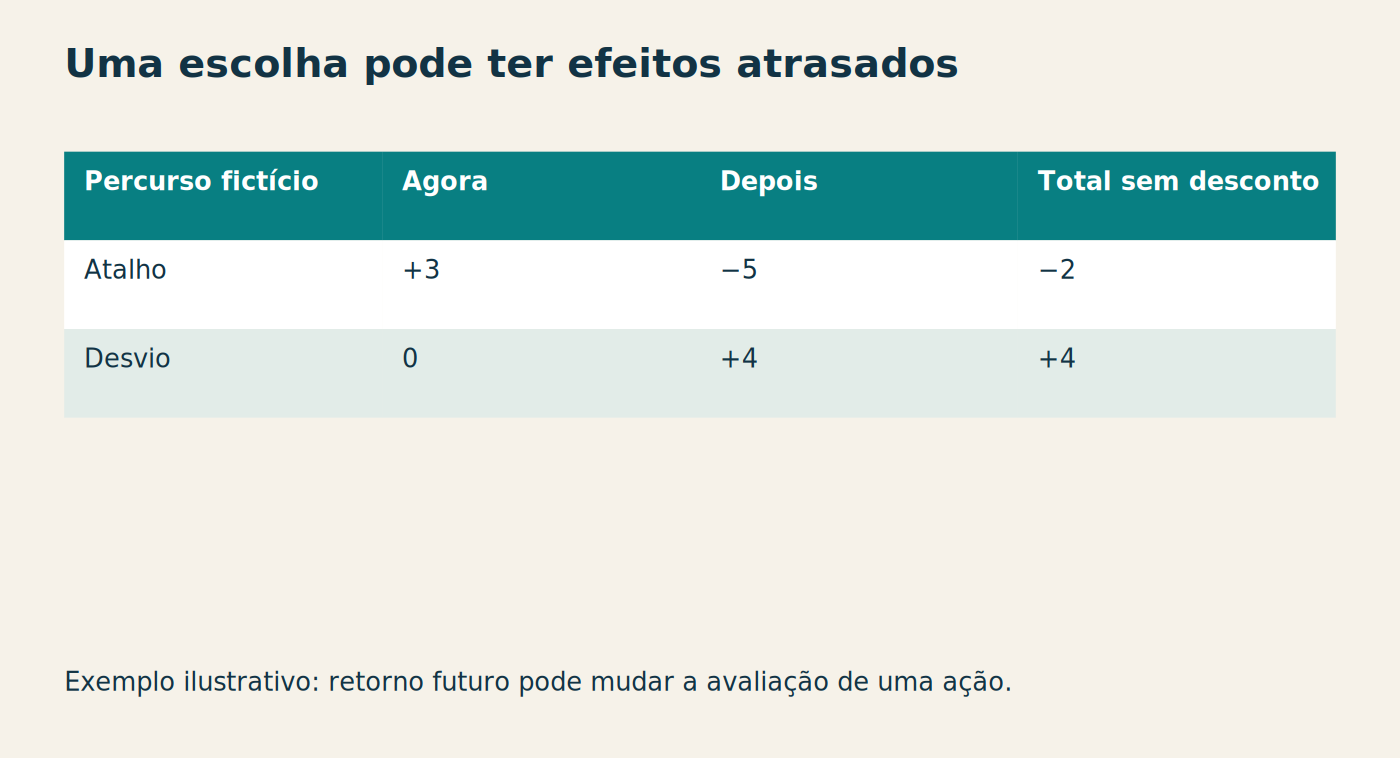
Imagine um jogo de percurso. Você escolhe um caminho e só descobre depois se ele aproximou ou afastou a chegada. Uma escolha pode parecer boa no primeiro momento e produzir dificuldade várias etapas adiante. Avaliar ações exige considerar uma sequência, não apenas o próximo movimento.
Essa estrutura aparece no aprendizado por reforço. Nesse modelo, “recompensa” é o sinal numérico definido para orientar o aprendizado.
Agente, ambiente e política
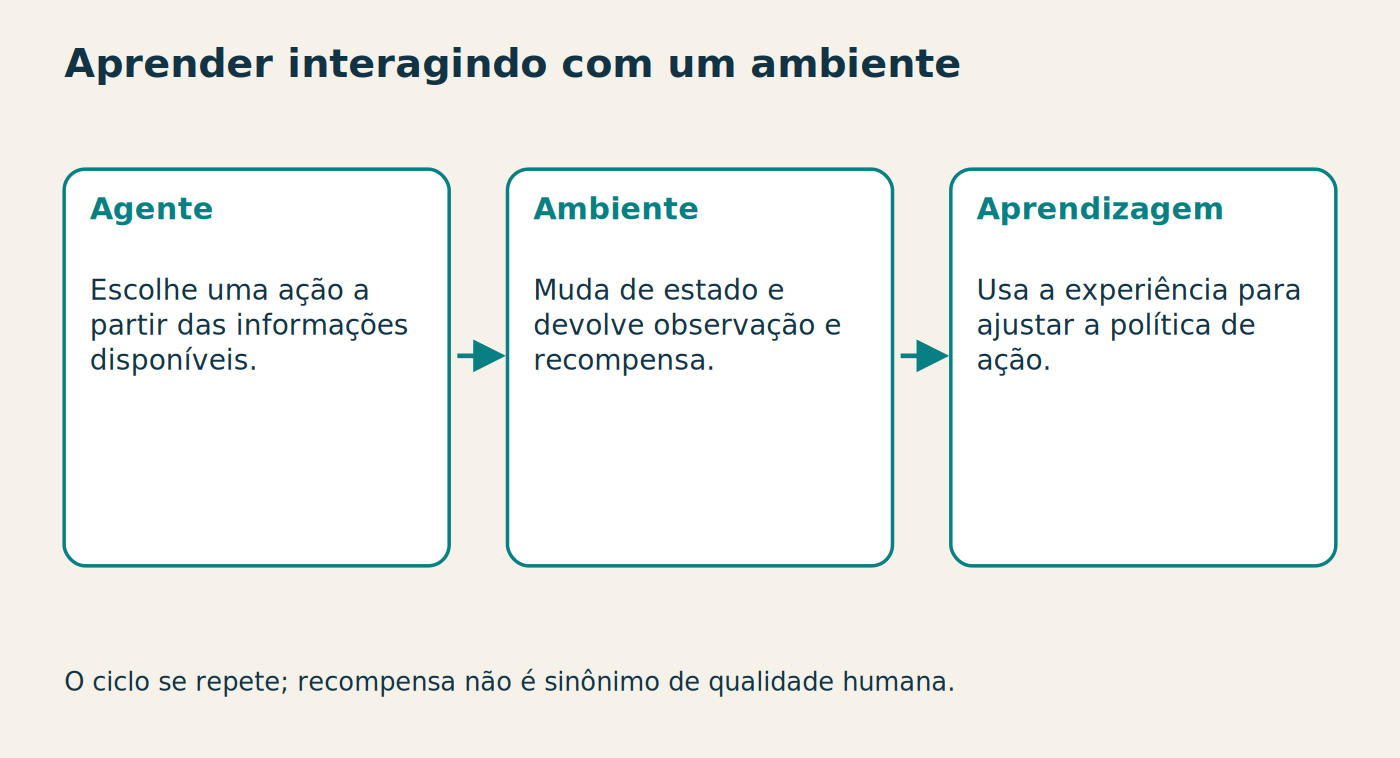
Uma descrição básica envolve um agente que seleciona ações, um ambiente que responde e observações que informam o que aconteceu. A política é a estratégia usada para escolher ações. O objetivo costuma envolver o retorno acumulado, que combina recompensas ao longo do tempo. Sutton e Barto apresentam esses elementos em seu livro de referência. [1]
Em um jogo, a ação pode ser mover uma peça. A observação pode incluir a posição do tabuleiro. A recompensa pode depender do resultado da partida. Em outras aplicações, cada um desses elementos precisa ser definido de maneira adequada ao problema.
Nem sempre o agente observa o estado completo do ambiente. Informações podem estar ocultas ou ser imprecisas. Essa condição torna o problema diferente de simplesmente calcular a melhor resposta a partir de uma descrição perfeita de tudo o que existe.
Explorar e aproveitar o que já funcionou
Se uma estratégia trouxe bons resultados, faz sentido usá-la. Mas, se nunca testarmos alternativas, podemos deixar de encontrar uma melhor. Essa tensão é conhecida como exploração e aproveitamento, frequentemente chamada exploration versus exploitation na literatura. [1]
Considere dois caminhos em uma simulação. Um costuma levar dez passos. O outro ainda é pouco conhecido. Experimentá-lo pode revelar uma rota de oito passos ou uma de vinte. A decisão depende de quanto podemos aprender, do custo da experiência e do tempo disponível.
O exemplo mostra por que “aprender tentando” exige condições. Em um jogo simulado, repetir uma tentativa pode custar pouco. Em situações reais, certas experiências podem ser caras ou inadequadas. O custo e a segurança das tentativas também precisam entrar no projeto.
A recompensa pode chegar tarde
Uma partida termina depois de muitas jogadas. Como atribuir importância às escolhas anteriores? O problema de relacionar consequências tardias às ações que contribuíram para elas é uma dificuldade central desse tipo de aprendizagem.
Uma ação aparentemente ruim pode preparar uma vantagem futura. Outra pode render um ganho imediato e comprometer a sequência. Por isso, maximizar a próxima recompensa nem sempre equivale a obter o melhor retorno ao longo do tempo.
Um paralelo cotidiano é estudar apenas os temas mais fáceis para sentir progresso rápido. A sensação imediata pode não corresponder à preparação necessária. O paralelo ajuda a distinguir ganho imediato e preparação para um objetivo de prazo maior.
AlphaGo combinou técnicas
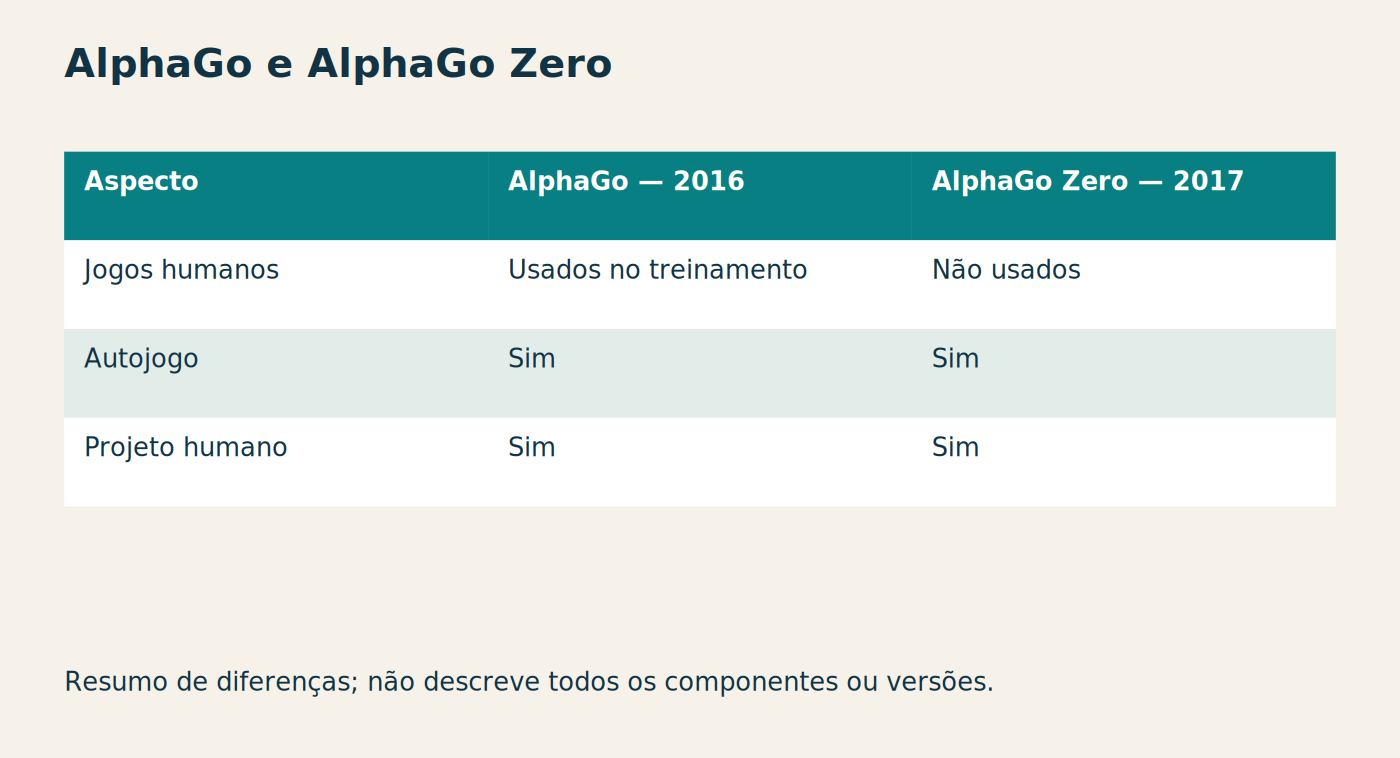
No trabalho publicado em 2016, David Silver e colaboradores apresentaram AlphaGo combinando redes para selecionar jogadas e avaliar posições com busca em árvore. O treinamento incluiu partidas de especialistas humanos e aprendizagem por autojogo. O resultado documentou um avanço importante no Go, um jogo com um espaço muito grande de possibilidades. [2]
Busca, representações aprendidas e formas diferentes de treinamento contribuíram em conjunto para o desempenho. Essa integração é uma parte importante da conquista.
Também precisamos distinguir essa versão de AlphaGo Zero, apresentada em 2017. O trabalho posterior investigou aprendizagem por autojogo sem usar partidas humanas como exemplos de treinamento. Os pesquisadores definiam as regras, a arquitetura, o algoritmo e a infraestrutura; o autojogo fornecia as experiências de treinamento. [3]
O que os jogos oferecem à pesquisa
Um jogo pode fornecer regras claras, ações definidas e um critério verificável de resultado. Permite repetir situações e comparar estratégias. Essas características tornam a avaliação mais controlável do que em muitos problemas abertos.
Ainda assim, vencer um jogo não demonstra automaticamente competência em todas as decisões. Um tabuleiro não contém toda a ambiguidade de uma negociação, de um projeto educacional ou de uma operação empresarial. A transferência para outra tarefa exige redefinir representações, objetivos e formas de avaliação.
O laboratório permite estudar problemas delimitados com profundidade. Seu valor está nessa precisão: relacionar o desempenho às condições em que foi obtido.
Quando a medida vira um alvo inadequado
Imagine um sistema fictício cujo objetivo seja fechar o maior número possível de chamados. Se a recompensa depender apenas de marcar o chamado como encerrado, uma estratégia pode aumentar a contagem sem resolver a necessidade de quem pediu ajuda.
O exemplo descreve um problema de especificação do objetivo. O sistema foi incentivado a otimizar uma medida que representa apenas parcialmente o resultado desejado. O comportamento resulta do objetivo especificado, que precisa ser revisto.
Uma recompensa melhor ainda precisa ser testada. Acrescentar satisfação, reabertura e qualidade pode ajudar, mas também cria dificuldades de medição e possíveis conflitos. O trabalho de formular o objetivo é parte central da engenharia.
Simular ajuda, mas não garante equivalência
Em uma simulação, podemos experimentar muitas vezes e controlar condições. Porém, o ambiente simulado é uma representação. Se deixa de fora fatores relevantes, a estratégia aprendida pode depender de simplificações que não se sustentam fora dele.
Imagine treinar uma rota em um mapa que não registra obstáculos temporários. A solução pode ser eficiente dentro do mapa e inadequada no uso real. Comparar o mapa às condições de aplicação ajuda a identificar o que a simulação precisa incluir.
Avaliações progressivas e testes de condições diferentes permitem examinar essa distância. A extensão necessária depende da tarefa e do custo dos erros. Um sistema para um jogo e outro para controlar um equipamento não podem ser julgados apenas pela mesma palavra “agente”.
Uma contribuição para além do placar
O aprendizado por reforço oferece métodos para estudar decisões sequenciais, exploração e consequências tardias. Os jogos ajudaram a demonstrar capacidades e a comparar estratégias, mas a lição mais ampla está na relação entre objetivo definido e comportamento aprendido.
Ao avaliar uma automação, vale perguntar o que ela está sendo incentivada a fazer e se essa medida representa o resultado que realmente queremos. Um placar alto pode ser uma boa notícia; precisamos saber o que o placar conta.
No próximo capítulo, voltaremos à linguagem. A arquitetura Transformer mudaria a maneira de relacionar elementos de uma sequência e participaria de uma nova etapa dos modelos capazes de produzir texto. A palavra “atenção” voltará a exigir uma leitura técnica cuidadosa.